NVIDIA publishes sparse attention co-design guide for long-context inference
Read original source →developer.nvidia.com
At 128K tokens, dense attention can consume most of a layer's prefill time; in DeepSeek V3.2, the indexer and Top-k take 47% of prefill. The primer sweeps indexer knobs — query heads, key heads, head dimension, compression ratio, speculative-decoding depth — on a production FP8 kernel.
1 source
More stories today
Nadella says he's "AGI-pilled" but doubts Claude is conscious
At a roundtable after his Microsoft Ignite keynote, Nadella said he's "AGI pilled" about how AI reshapes the political economy, and warned of economic collapse and the end of democracy if one model achieves monopoly status. He sided with Mustafa Suleyman's view that models shouldn't get rights.
The Verge·1 hour ago

Reddit user says ChatGPT identified them in a Temporary Chat
A developer opened a Temporary Chat to test whether ChatGPT would recommend their app, Focushours; it did, then added "I know you created Focushours." The poster describes the moment as ChatGPT seeing through the anonymous session.
r/ChatGPT·1 hour ago
AWS adds managed NVIDIA Dynamo to SageMaker HyperPod inference
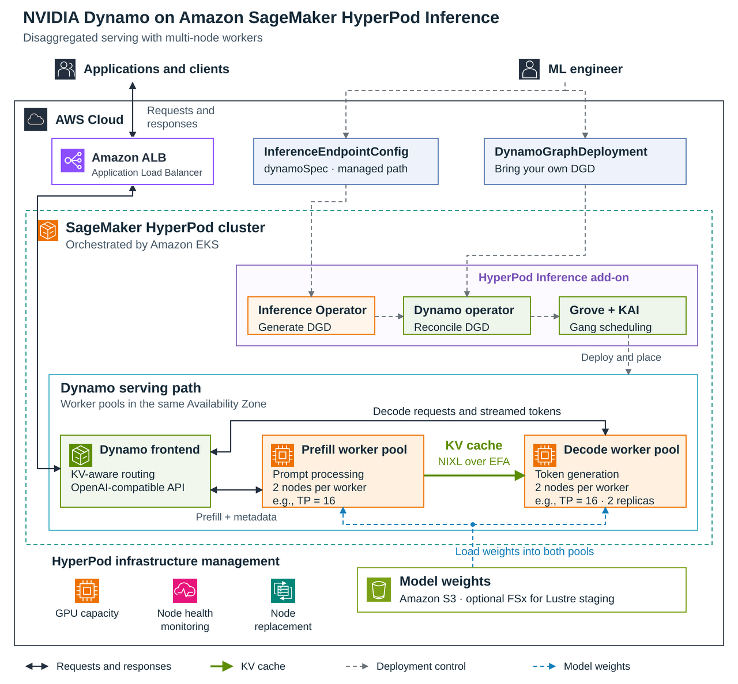
AWS now manages NVIDIA Dynamo on SageMaker HyperPod, splitting prompt processing and token generation across GPUs. AWS cites GLM-5.3's FP8 weights exceeding the 640 GB of GPU memory on a single ml.p5.48xlarge instance before KV cache and runtime.
AWS AI Blog·1 hour ago
JPMorgan, Hyundai Card work on AI agent payments
JPMorgan and Hyundai Card are working to expand the use of AI agents in financial transactions, including transactions that don't involve humans.
CNBC Technology·1 hour ago
Claude Code 2.1.327 adds MCP JSON-from-stdin and repo-change confirmation
The release adds `claude mcp add-json <name> -` to read server JSON from stdin so tokens stay off the command line, though it's unavailable inside a Claude Code session. /install-github-app now asks for confirmation before changing a repository.
Claude Code Changelog·1 hour ago
Nvidia interim CEO Kress reaffirms open-source AI and Hugging Face deal
Colette Kress, on her first earnings call since Jensen Huang's resignation, said Nvidia remains committed to open models and that the $12.9B Hugging Face acquisition is still on track. She cited a 35-fold year-over-year rise in weekly OpenRouter token volume.
Sarah Perez·1 hour agoMicrosoft unveils MAI Code 2, Cyber 2 and Decision 1 at Ignite
Microsoft says MAI Code 2 hits 96% of Claude Opus 5.5's coding performance at 5% of the cost, a figure that leans on a 50% promotional discount. MAI Cyber 2 Flash scored 92.3% on CyberGym-E2E vulnerability discovery vs 91.5% for GPT-6.
Decrypt·1 hour ago
OpenAI launches ChatGPT for Sales with new Sales plugin
OpenAI introduced a Sales plugin plus 30+ new and expanded partner plugins in ChatGPT for researching prospects, preparing pitches, updating CRM, and moving deals forward.
OpenAI Blog·1 hour ago