Liquid AI launches RIPL real-time inference engine for LFMs
Read original source →marktechpost.com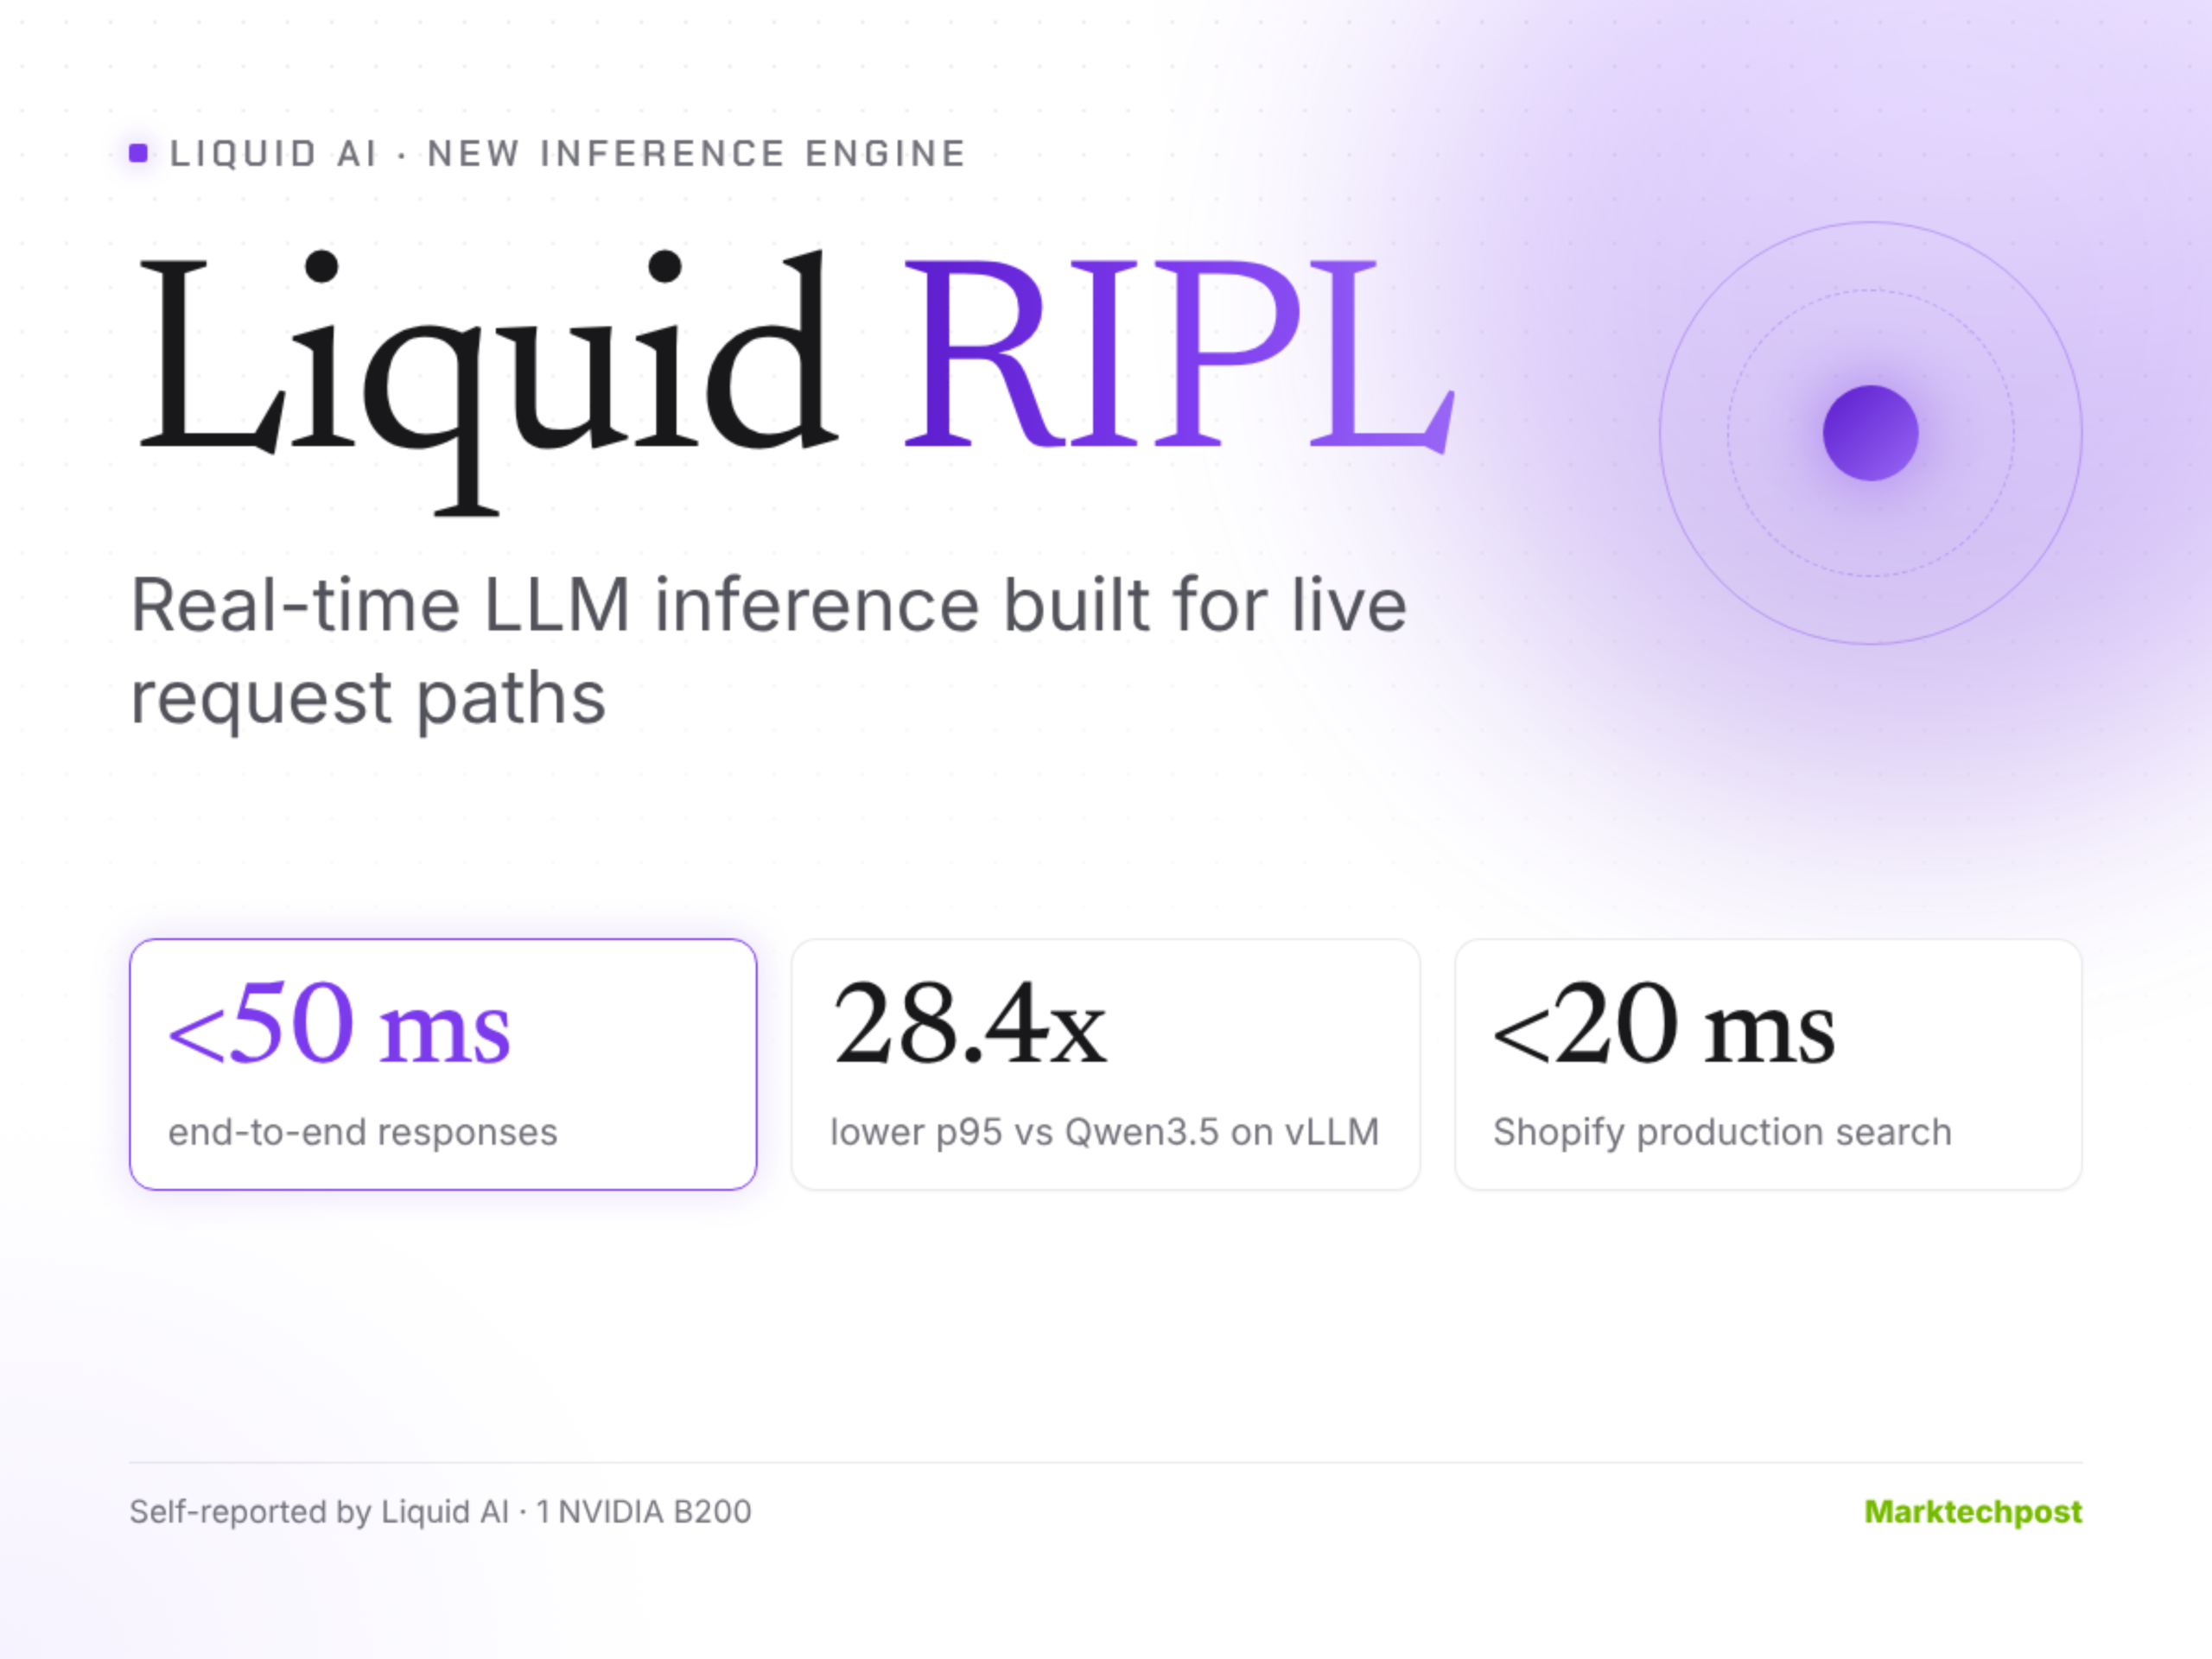
RIPL serves LFM2.5 models (230M–2.6B params) end-to-end in under 50 ms on NVIDIA H100/H200/B200 and RTX PRO 6000 GPUs. Liquid's own tests show 5.6–28.4x lower p95 latency than Qwen3.5 on vLLM; sub-50 ms fails on longer requests.
1 source
More stories today
Databricks outlines new economics of AI cost management
Databricks blog post argues enterprise AI adoption discussions have centered on a different story for the past two years, and reframes the conversation around cost management. The post is filed under Databricks' "Data + AI Foundations" category.
Databricks Blog·2 hours ago
Letta's FrontierMemory benchmark tests whether agents use what they remember
Letta released FrontierMemory on Wednesday, measuring whether agents can apply past experience to improve later work rather than just recall it. Five AI agent harnesses took the test and the results diverged sharply.
The New Stack·2 hours ago
Schwarzman says he found the AI revolution 'by accident' in 2015
Blackstone CEO Stephen Schwarzman credits Jack Ma with helping him discover the AI revolution 'by accident' in 2015, recounting the story on Bloomberg's 'Leaders With Francine Lacqua.'
Bloomberg Technology·2 hours ago
Databricks details real-time telecom fraud detection AI coworker
Databricks blog describes a fraud-analyst AI coworker that detects telecom fraud in real time on a single platform, citing the Communications Fraud Control Association's 2025 survey as background.

Cohere launches Confidential Computing on Model Vault in public beta
Public beta runs on NVIDIA GPUs on Microsoft Azure, extending hardware-backed isolation to GPU memory and encrypting CPU-GPU traffic during inference. Remote attestation lets customers verify signed evidence of hardware, firmware, and software config before sending plaintext.
Cohere Blog·2 hours ago
Google's Project Chrysalis cuts outage mitigation to 1.8 seconds
Google Cloud's reference architecture, codenamed Project Chrysalis, cut time-to-first-mitigation from 15–45 minutes to 1.8 seconds in simulated Black Friday cache-stampede outages. It also dropped HTTP 5xx error rates from 72.7–80.0% to 0.0% and P99 latency from 519.8 ms.
Google Developers Blog (AI)·2 hours ago

Anthropic: folding subagents into one agent loop can beat multi-agent designs
Anthropic's Applied AI team says a single agent with skills often outperformed both one-prompt-for-everything and subagent designs on quality, usually at lower cost and latency per task. One company's dozen specialist subagents hurt on-brand consistency and added latency; a migration kit helps identify foldable patterns.
Claude Blog·2 hours ago
Zuckerberg: Meta's Muse agents will out-earn Instagram and Facebook
On Meta's Q3 earnings call, Zuckerberg said he sees "billions" of people using Muse, the personal AI agent released to the public last month, with users' Muses transacting with each other in a "large-scale Muse network." He predicted Muse will eventually generate more revenue per user than Instagram and Facebook.
The Verge·2 hours ago
