Cerebras explains latency vs throughput in AI inference
Read original source →youtube.com
Cerebras breaks down the two sides of AI performance: latency is response time from prompt to result, including Time to First Token and inter-token latency.
1 source
More stories today
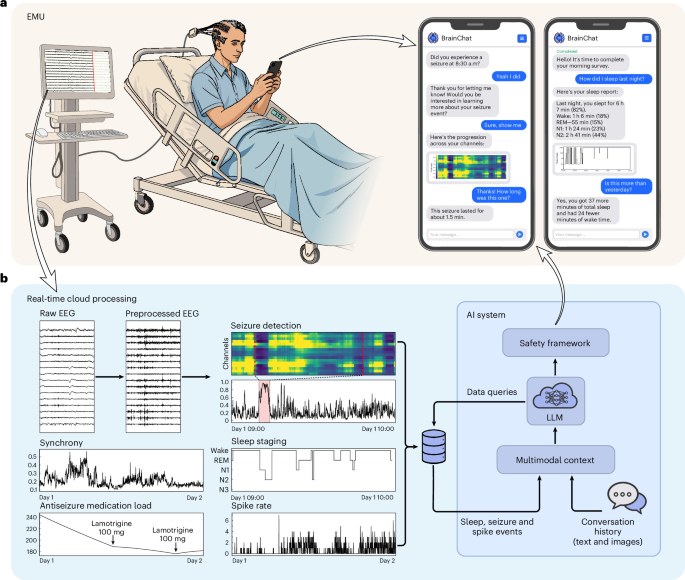
LLM chat interface lets epilepsy patients talk to their EEG in real time
Nature Medicine study validated the platform in 13 patients (11 scalp, 2 intracranial EEG); the AI reports sleep, medication, cognition and seizure-probability biomarkers via smartphone app. In a pseudoprospective simulation, seizure detectors improved precision from patient feedback alone, without expert intervention.
Nature Medicine (News)·1 hour ago
Suno users say v6 is a downgrade from v4.5
r/SunoAI threads complain v6 sounds "muddy and awful" with runaway drums around the 2-minute mark, and that remastering v4.5 tracks no longer works. One user says they'd pay $100/month to get v4.5 back; another calls paying a download slot for previously downloaded and stemmed songs "criminal."
r/SunoAI·1 hour ago
ByteDance proposes few-step generation via data-space iteration
ByteDance researchers posted a paper (arXiv 2610.12102) on a new few-step distillation method for diffusion generation, shared to r/StableDiffusion. The Reddit poster notes it is "another" few-step distillation method from the company.
r/StableDiffusion·1 hour ago
Reddit user uses Claude to flag Medicare fraud in CMS data
A Reddit user asked Claude to spot red flags in publicly available 2024 CMS data; most flagged entities turned out to be companies already known to authorities.
r/ClaudeAI·1 hour agoClaude users get free usage limit resets
Anthropic has added limit resets to Claude, letting users reclaim usage after hitting caps; a Reddit user reported using their free reset for the first time. Anthropic's support docs describe the feature as a 'limit reset.'
r/ClaudeAI·1 hour agoReddit user benchmarks Qwen 3.8 Flash Next Q3 S in Opencode
A LocalLLaMA user ran benchmark tests on multiple models in Opencode after being impressed by Exo's results, reporting that many models performed poorly, especially mid-level ones.
r/LocalLLaMA·1 hour ago
Looped Diffusion Transformer reuses blocks per denoising step
Paper (arXiv 2609.40305) runs a shared group of transformer blocks several times inside each denoising step instead of scaling up a text-to-image DiT. Naive looping didn't reliably help; the authors fix it with deep supervision on every loop, and loop depth can be changed at sampling time.
r/MachineLearning·1 hour ago
Microintelligence files for Hong Kong listing
Changzhou-based Microintelligence published its post-hearing information pack on October 9 for a Hong Kong listing. Founded in 2018, it began with AI-powered quality inspection and now combines sensing, software and robotic control. CEO Zhang Zhiqi said a die-cast part needing ~3,000 imaging positions took a fixed-path robot an hour versus 7-8 minutes for a skilled worker.
TechNode·1 hour ago
