Qwen3.8-Flash-Next-GSQ-RCO runs at 20-30 tok/sec on 12GB VRAM
Read original source →reddit.com
A custom Strata fork runs the IQ3_S quant of Qwen3.8-Flash-Next-GSQ-RCO-Abliterated at 20-30 tok/sec decode and 300 to ~90k tok/sec prefill at 131k context on 12GB VRAM plus 32GB RAM. The Q2 quant reaches 39-45 tok/sec decode.
1 source
More stories today
Google reportedly testing internal Gemini checkpoint "Carbon"
Kimmonismus·1 hour ago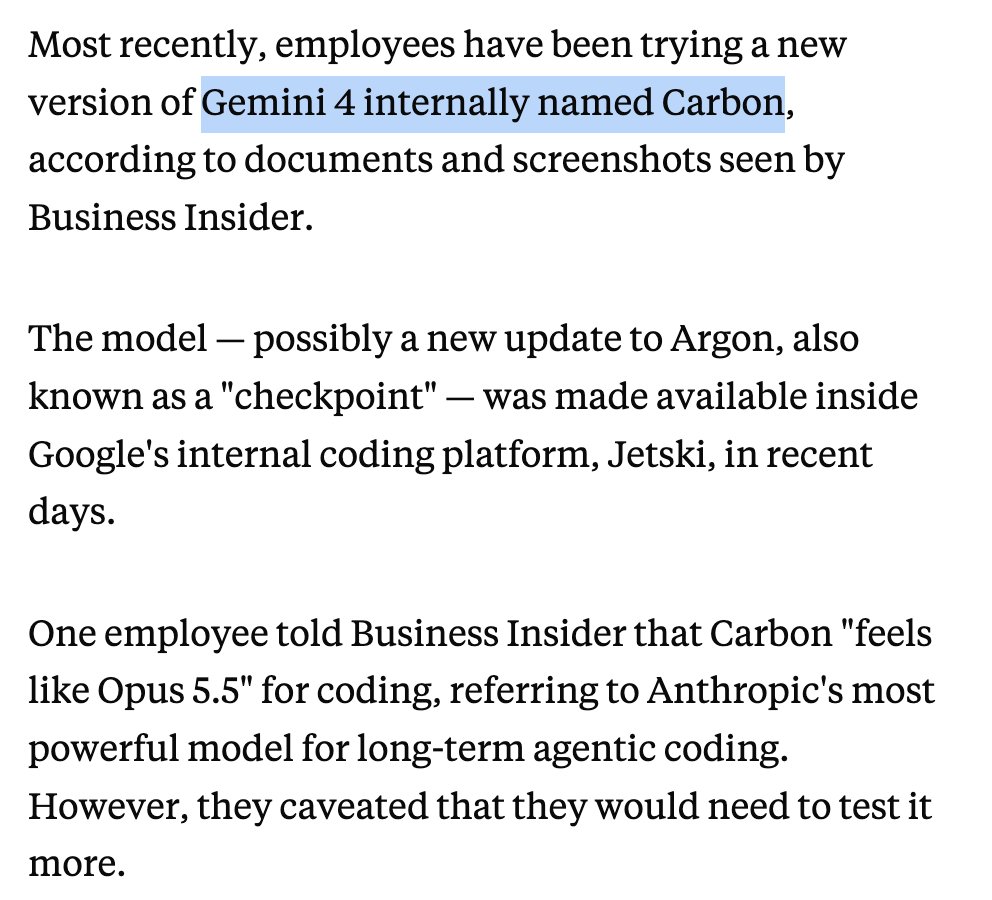
Simbe completes rollout of 3,000 Tally robots globally
Simbe Robotics has finished deploying 3,000 Tally shelf-scanning robots across retailers and countries, with an ongoing rollout at a Tier 1 retailer set to grow that number. Badger Technologies is also repositioning from robotics to a retail intelligence company, per new CEO John Gehre.
The Robot Report·1 hour ago

Meta proposes alternative to scaling compute for AI agents
Meta researchers argue that giving AI agents more compute at inference time is not enough, and propose a different approach in a new paper covered by VentureBeat.
VentureBeat·1 hour ago
Cohere explains shared vs dedicated inference for Embed & Rerank
Cohere's guide frames the choice around request profile, traffic pattern, and utilization rather than headline price. It contrasts bulk indexing jobs (~100 descriptions per request, ~200 tokens each) with single short search queries where latency matters.
Cohere Blog·1 hour ago
Essay argues AI erodes the intellectual communities that sustain software work
Essay contends AI dissolves the human intellectual communities that make private intellectual activity possible, citing software engineering's shift from compilers and type systems to "prompts," "harnesses," and "loops." It argues prompting is a shallower skill than software engineering, so human capital formation has collapsed.
Hacker News·1 hour ago
Claude Code Projects beta rolls out with parallel task threads
Anthropic's Claude Code Projects runs each task as its own thread in parallel within one ongoing conversation. The feature is in beta and rolling out, with support for steering threads, reviewing pull requests, creating artifacts, and scheduling routines.
YouTube·1 hour ago
Claude Code 2.1.296 adds gateway code key and subagent auto-compact
Claude Code v2.1.296 adds a code key to the Claude apps gateway's managed.policies[], applying cli settings in Claude Desktop's Code tab and enabling gateway mode. Subagent frontmatter gains autoCompactWindow so subagents can compact earlier than the main conversation.
Claude Code Changelog·2 hours ago
AI coding agents generate more code, but not more software
Harvard researchers analyzed 300M work events across 700+ firms and 700,000 employees from 2021 to March 2026, finding little evidence AI coding tools raise software output or cut employment. Efficiency gains in coding are absorbed by longer code reviews, more PR revisions, and more reviewer comments.
Ars Technica·2 hours ago