LocalLLaMA user prefers long context over larger MoE models
Read original source →reddit.comA r/LocalLLaMA poster argues a 27B model at 1M context beats a big MoE capped at 128k, saying extra resources are better spent on context than parameters. They run a 400k-context Qwen model plus web search to cover gaps in world knowledge.
1 source
More stories today
Commentator says AI progress is outpacing even optimistic forecasts
Kimmonismus·1 hour ago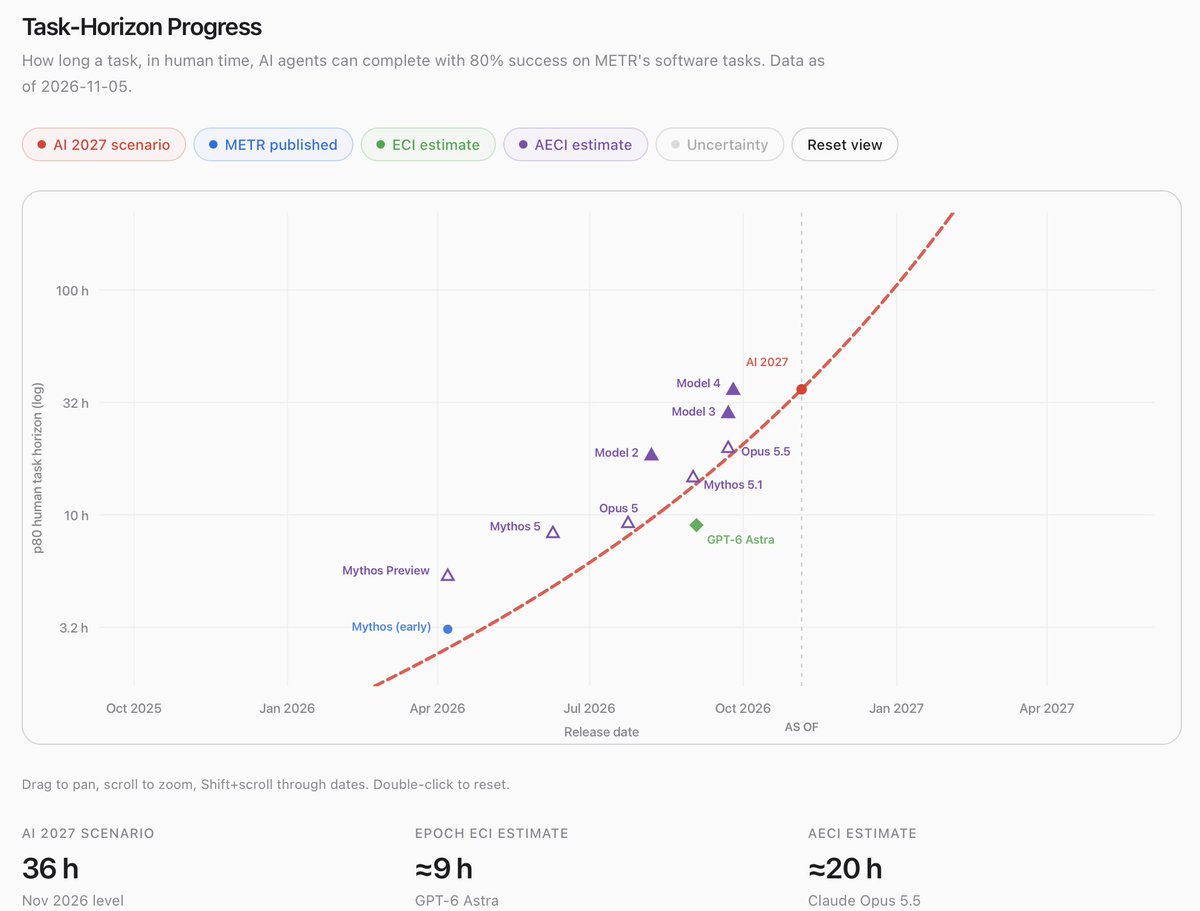
Weta FX chief says studios now shun VFX vendors without an AI plan
Weta FX CEO Daniel Seah said studios that banned GenAI in early 2025 now ask vendors about AI strategy, with the message since Q3: "If you don't have an AI strategy, don't bother to work with us." Weta partnered with Taiwan's Moonshine Studio and builds its own models for world modification, not ChatGPT-style LLMs.
r/OpenAI·1 hour ago
Reddit post explains how image generator restrictions work
A r/ChatGPT user walks through how image generator content restrictions work, saying many users wrongly blame the assistant for refusals. The post is written as a simplified explainer for people unfamiliar with the generator.
r/ChatGPT·1 hour agoEngineer asks whether AI will cause stagnation in software engineering
A Hungarian software engineer with ~14 years of experience argues that AI-driven coding risks a loss of innovation, citing 1.5 years of watching the shift with concern. The post is a discussion prompt on r/ExperiencedDevs, not a study or data-backed finding.
r/ExperiencedDevs·1 hour agoStep 5 serving stack triples throughput on StepFun TTFT/TPS targets
Together AI·1 hour ago
Developer builds self-evolving Backrooms game with Opus 5.5
A Reddit user built dimension9.space, a browser-playable Backrooms game where Opus 5.5 follows a standing directive to keep generating new rooms, characters, and entities. The creator says the world keeps changing beyond their own knowledge of its contents.
r/ClaudeAI·1 hour ago
Reddit post claims Opus 5.5 rises on Benchmaxxing Bench
A single r/ClaudeAI post says Opus 5.5 "goes UP" on the Benchmaxxing Bench, with no score, chart, or methodology given. The post offers only the comment that the weights are "blessed."
r/ClaudeAI·2 hours ago
Scale AI to launch Muse model this week
Alexandr Wang·2 hours ago