llama.cpp adds fused op for QSA mask to speed up sparse attention
Read original source →github.com
Pull request #30640 by am17an adds a fused QSA mask operation to ggml-org/llama.cpp, targeting speedups for sparse attention models.
1 source
More stories today
AT&T Connected Life adds Gemini for Home security features
AT&T's Connected Life is the first home security system to integrate Google Home Premium, adding Gemini-powered event summaries and natural-language video search. Features require the $29.99/month professional monitoring plan.
The Verge·2 hours ago

Onyx benchmarks 39 AI assistants on 500 questions over 500,000+ docs
Hasan Toor·2 hours ago
Community builder creates action LoRA for MiniMax H3 without training
Instead of training, the creator diffed Singularity v2 and v1.3 checkpoints layer by layer to isolate where v2's stronger action behavior lives, then moved only that portion onto v1.3. The same approach was applied to JOKER141's Motion Repair V2.
r/StableDiffusion·2 hours ago
Datasette Agent 0.5a0 adds side panel for chatting next to database pages
The alpha release introduces a "panel" that keeps the agent chat open alongside Datasette table or query pages. Combined with datasette-apps, users can prompt a database-backed app into existence and then modify it from the adjacent chat.
Simon Willison's Weblog·2 hours ago
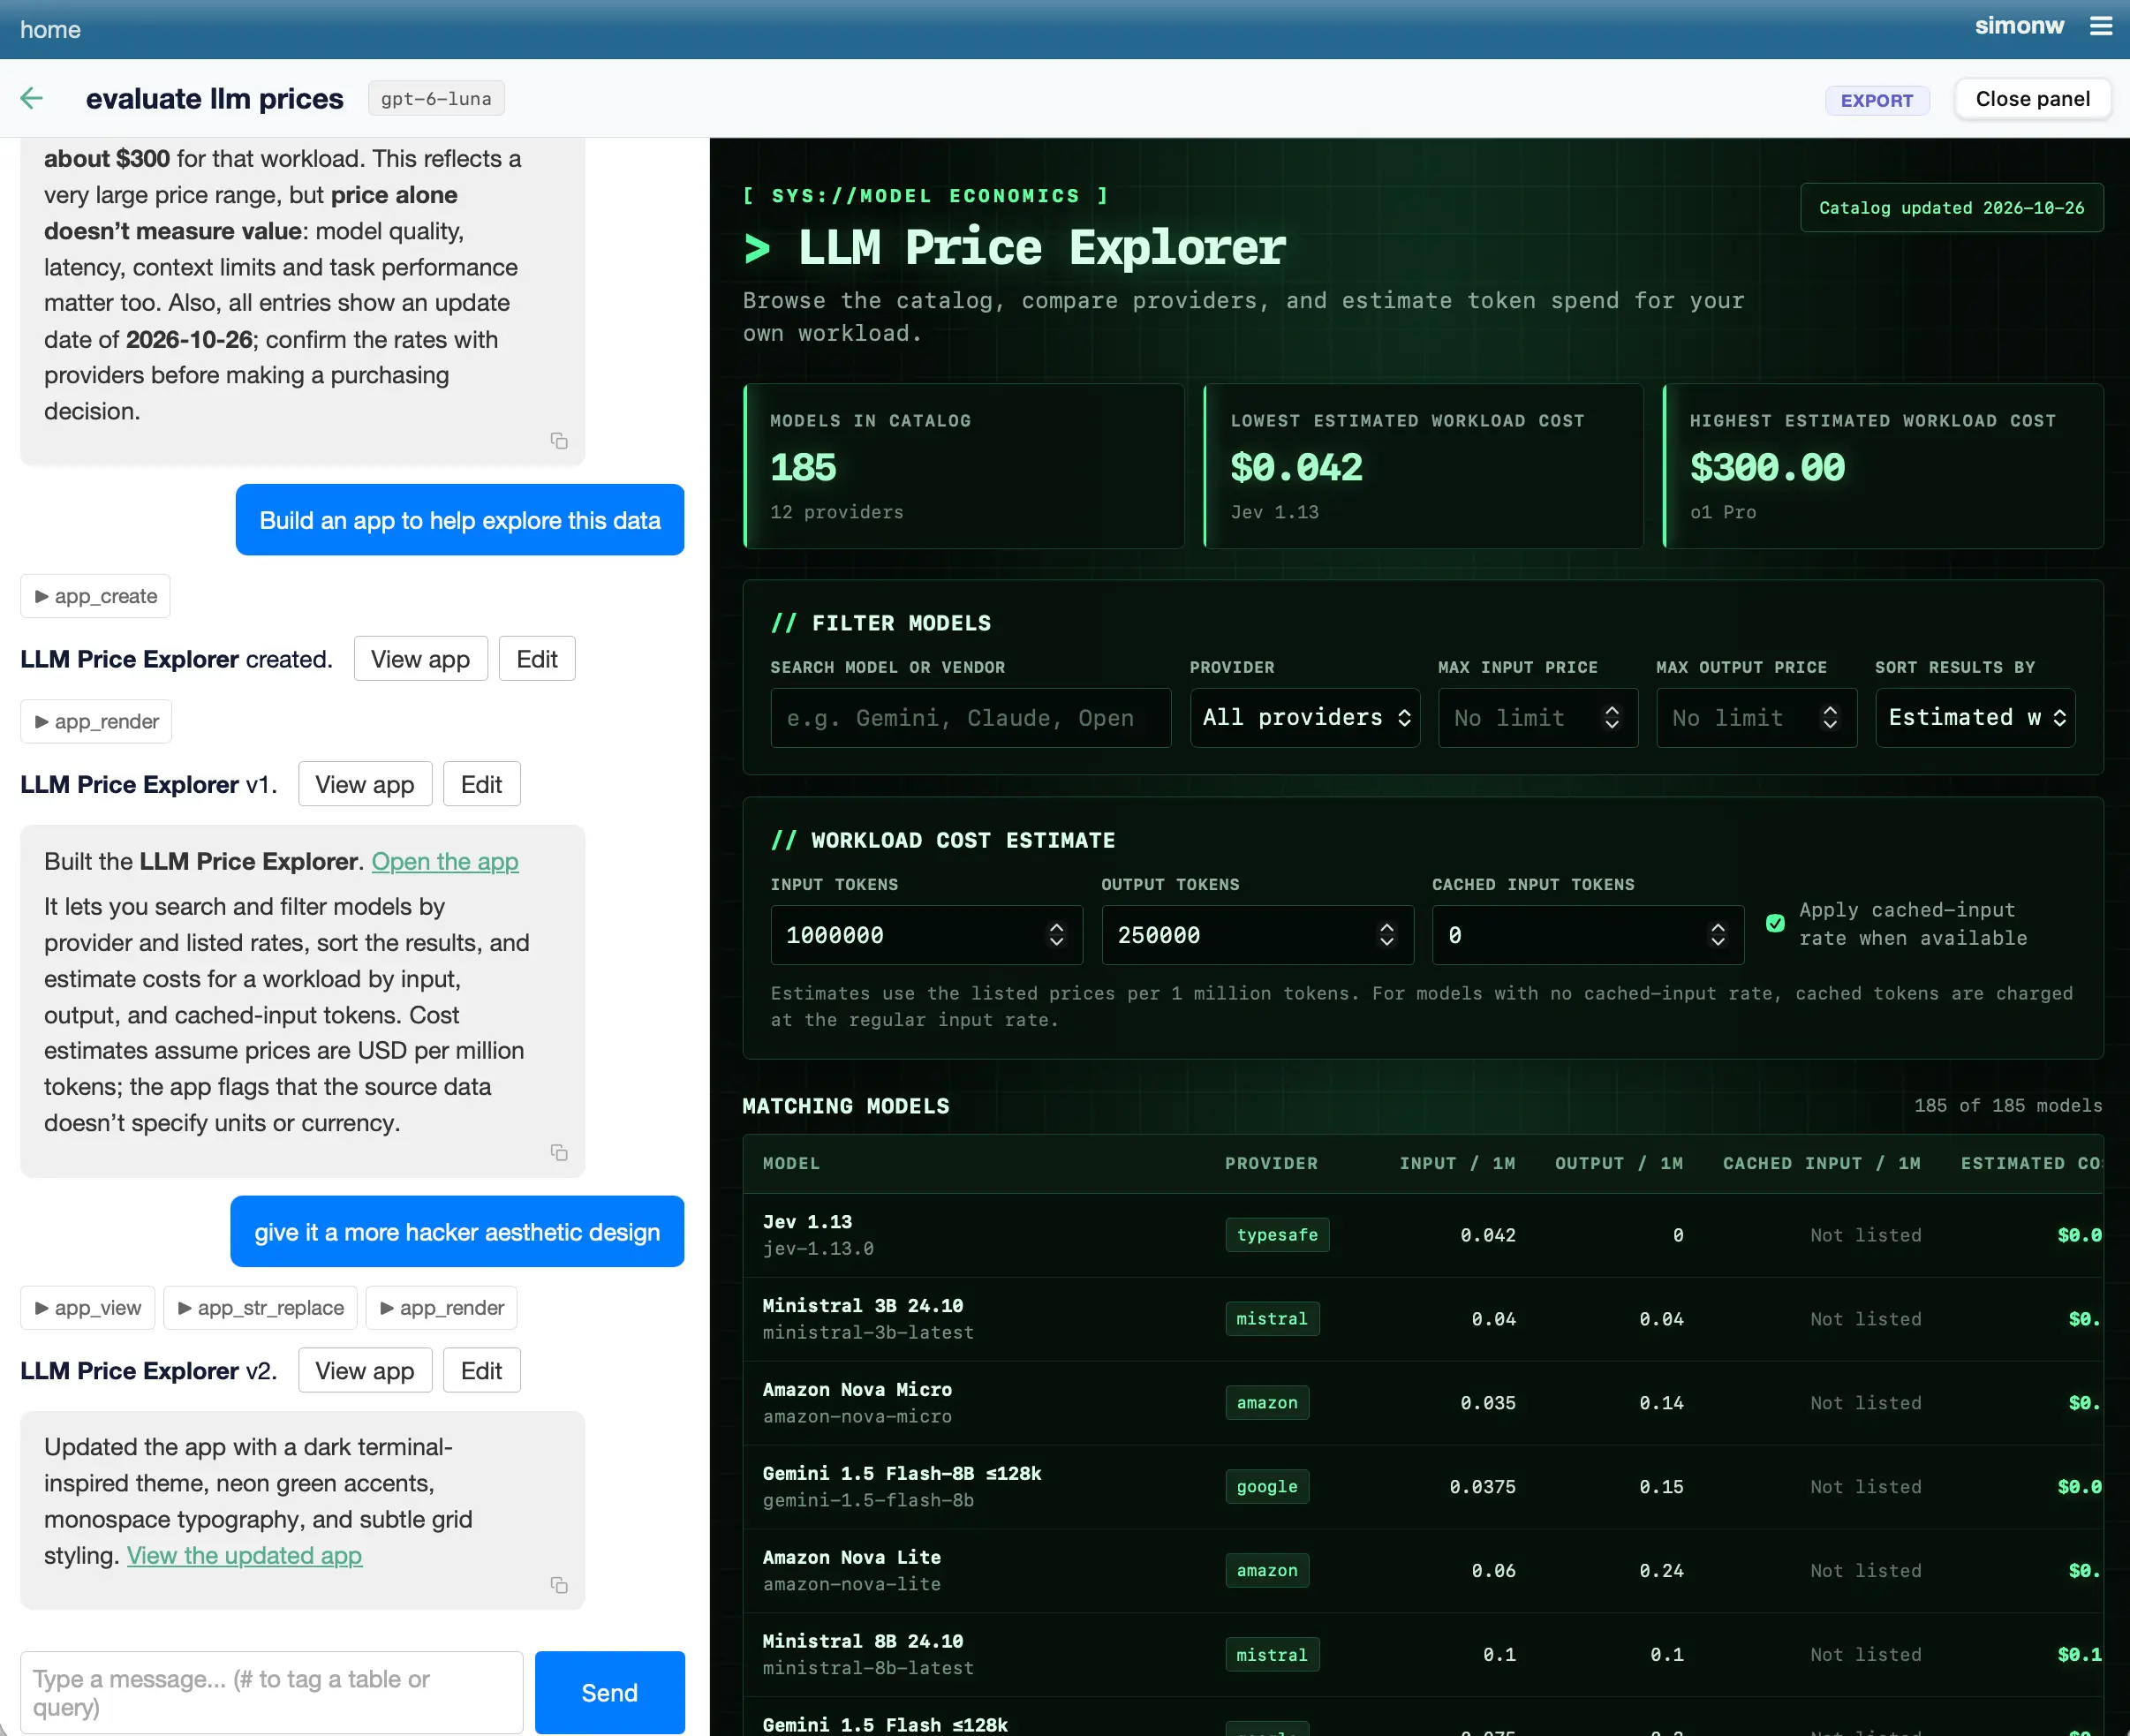
Datasette Apps 0.3a0 adds LLM-driven app editing via Datasette Agent
Apps can now be tagged in Datasette Agent chat with #, autocompleting from apps the user can view. New app_add_stored_queries() and app_remove_stored_queries() tools let the agent manage an app's stored queries, with user approval required for write queries.

Claude Marketplace adds security and dev agents, passes 25 partners
Anthropic added agents from Chainguard, Checkmarx, Cyera, Rubrik, Tanium and Datadog to Claude Marketplace, which now hosts over 25 partner agents and products. Eligible enterprise customers can apply committed Anthropic spend toward partner tools.
Claude Blog·2 hours ago
Berkeley and DeepMind study: AI writing shifts authors' meaning
Nav Toor·2 hours ago
Claude used to map first 3D structure of a vault particle
Anthropic·2 hours ago