Cerebras video series explains AI inference metrics
Read original source →youtube.com
Cerebras' "Cerebras Explains" series covers cost per token, Time to First Token, tokens per second, and inference APIs. One episode argues AI speed is determined by infrastructure, not the model, citing 1,000+ tokens per second.
How this story unfolded
4 weeks · 9 reports · from Sep 25
- Sep 25
- Sep 30
- Oct 1
- Oct 2
- Oct 19
- Oct 20
More stories today
Reddit user tests MiniMax h3 image editing
A r/StableDiffusion post shows generations from MiniMax h3, all produced in one attempt, with the poster noting one failure on pose.
r/StableDiffusion·5 hours ago
Susan Rice warns of AI extinction risk at protest
Former national security advisor Susan Rice said at a protest that "there is nothing more urgent than stopping AI from achieving super intelligence and causing human extinction." The remark was shared on r/OpenAI.
r/OpenAI·5 hours ago
Datasette Apps 0.4a0 adds URL fragment linking between apps
Datasette Apps are sandboxed HTML/JS apps inside Datasette that can run SQL queries against your data, comparable to Claude Artifacts. Version 0.4a0 lets apps read #fragments from the URL and reports supported URL schemes to Datasette Agent so it can write apps that link to each other.
Simon Willison's Weblog·5 hours ago

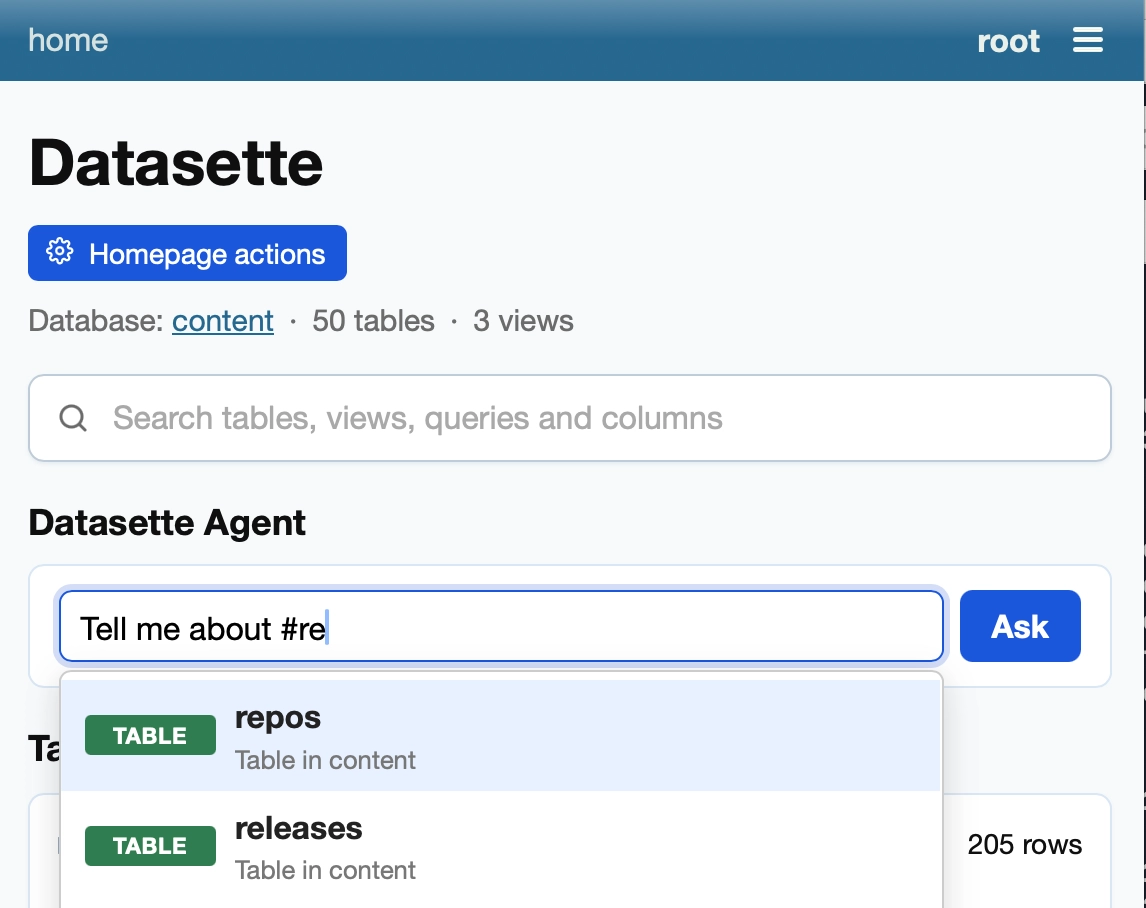
Datasette-agent 0.6a0 adds agent prompt to Datasette homepage
The alpha release bundles accumulated small fixes for Simon Willison's Datasette agent plugin, which lets users ask questions about their data. The new homepage prompt supports hash-mentions of tables and queries.
Alibaba launches Qwen4-Max flagship model
Alibaba claims Qwen4-Max tops coding benchmarks, beating Anthropic's Claude Fable 5.1 and Moonshot's Kimi K3.1 Pro. It ships closed-weight with native vision and a 1M-token context window; smaller open versions promised soon.
Hacker News·7 hours ago
Morgan Stanley goes 'max overweight' global stocks on AI cycle
Morgan Stanley strategists, including Serena Tang, recommended a "max overweight" in global stocks, citing an intact AI capital spending cycle. The bank upgraded Japanese and European equities to overweight, kept US overweight and EM equal weight, and lifted its S&P 500 target to imply 15% upside.
Bloomberg Technology·7 hours ago
Reddit user questions Anthropic's future under shareholder pressure
A r/ClaudeAI poster calls Claude "true life altering tech" with "incredible" value today, but says they "feel dread" about what happens when profit for shareholders becomes the priority.
r/ClaudeAI·8 hours agoApple and OpenEvidence launch AI health chat study app
Apple is recruiting up to 200,000 US participants aged 21+ with iPhone 15 or later for a study running over 12 months, using an app built with clinical AI platform OpenEvidence. Answers cite peer-reviewed sources like NEJM, JAMA and Nature; data is anonymized and not used to train AI models.
TechCrunch·8 hours ago
