New papers tackle LLM pruning, quantization efficiency
Read original source →arxiv.orgFour arXiv papers propose methods to reduce LLM inference cost: low-rank importance pruning, depth-pruning distribution shift correction (SHIFT-LLM), Fisher-information-based mixed-precision quantization (FAMPWQ), and zero-search quantized LoRA (AQLoRA). A fifth evaluates quantization effects on Bangla.
How this story unfolded
3 days · 9 reports · from Aug 25
- Aug 25
- Aug 26
- Aug 27
FAMPWQ: Fisher Information-based Adaptive Mixed Precision Weight Quantization for Effective LLM Inferencearxiv.org
- Aug 28
More stories today
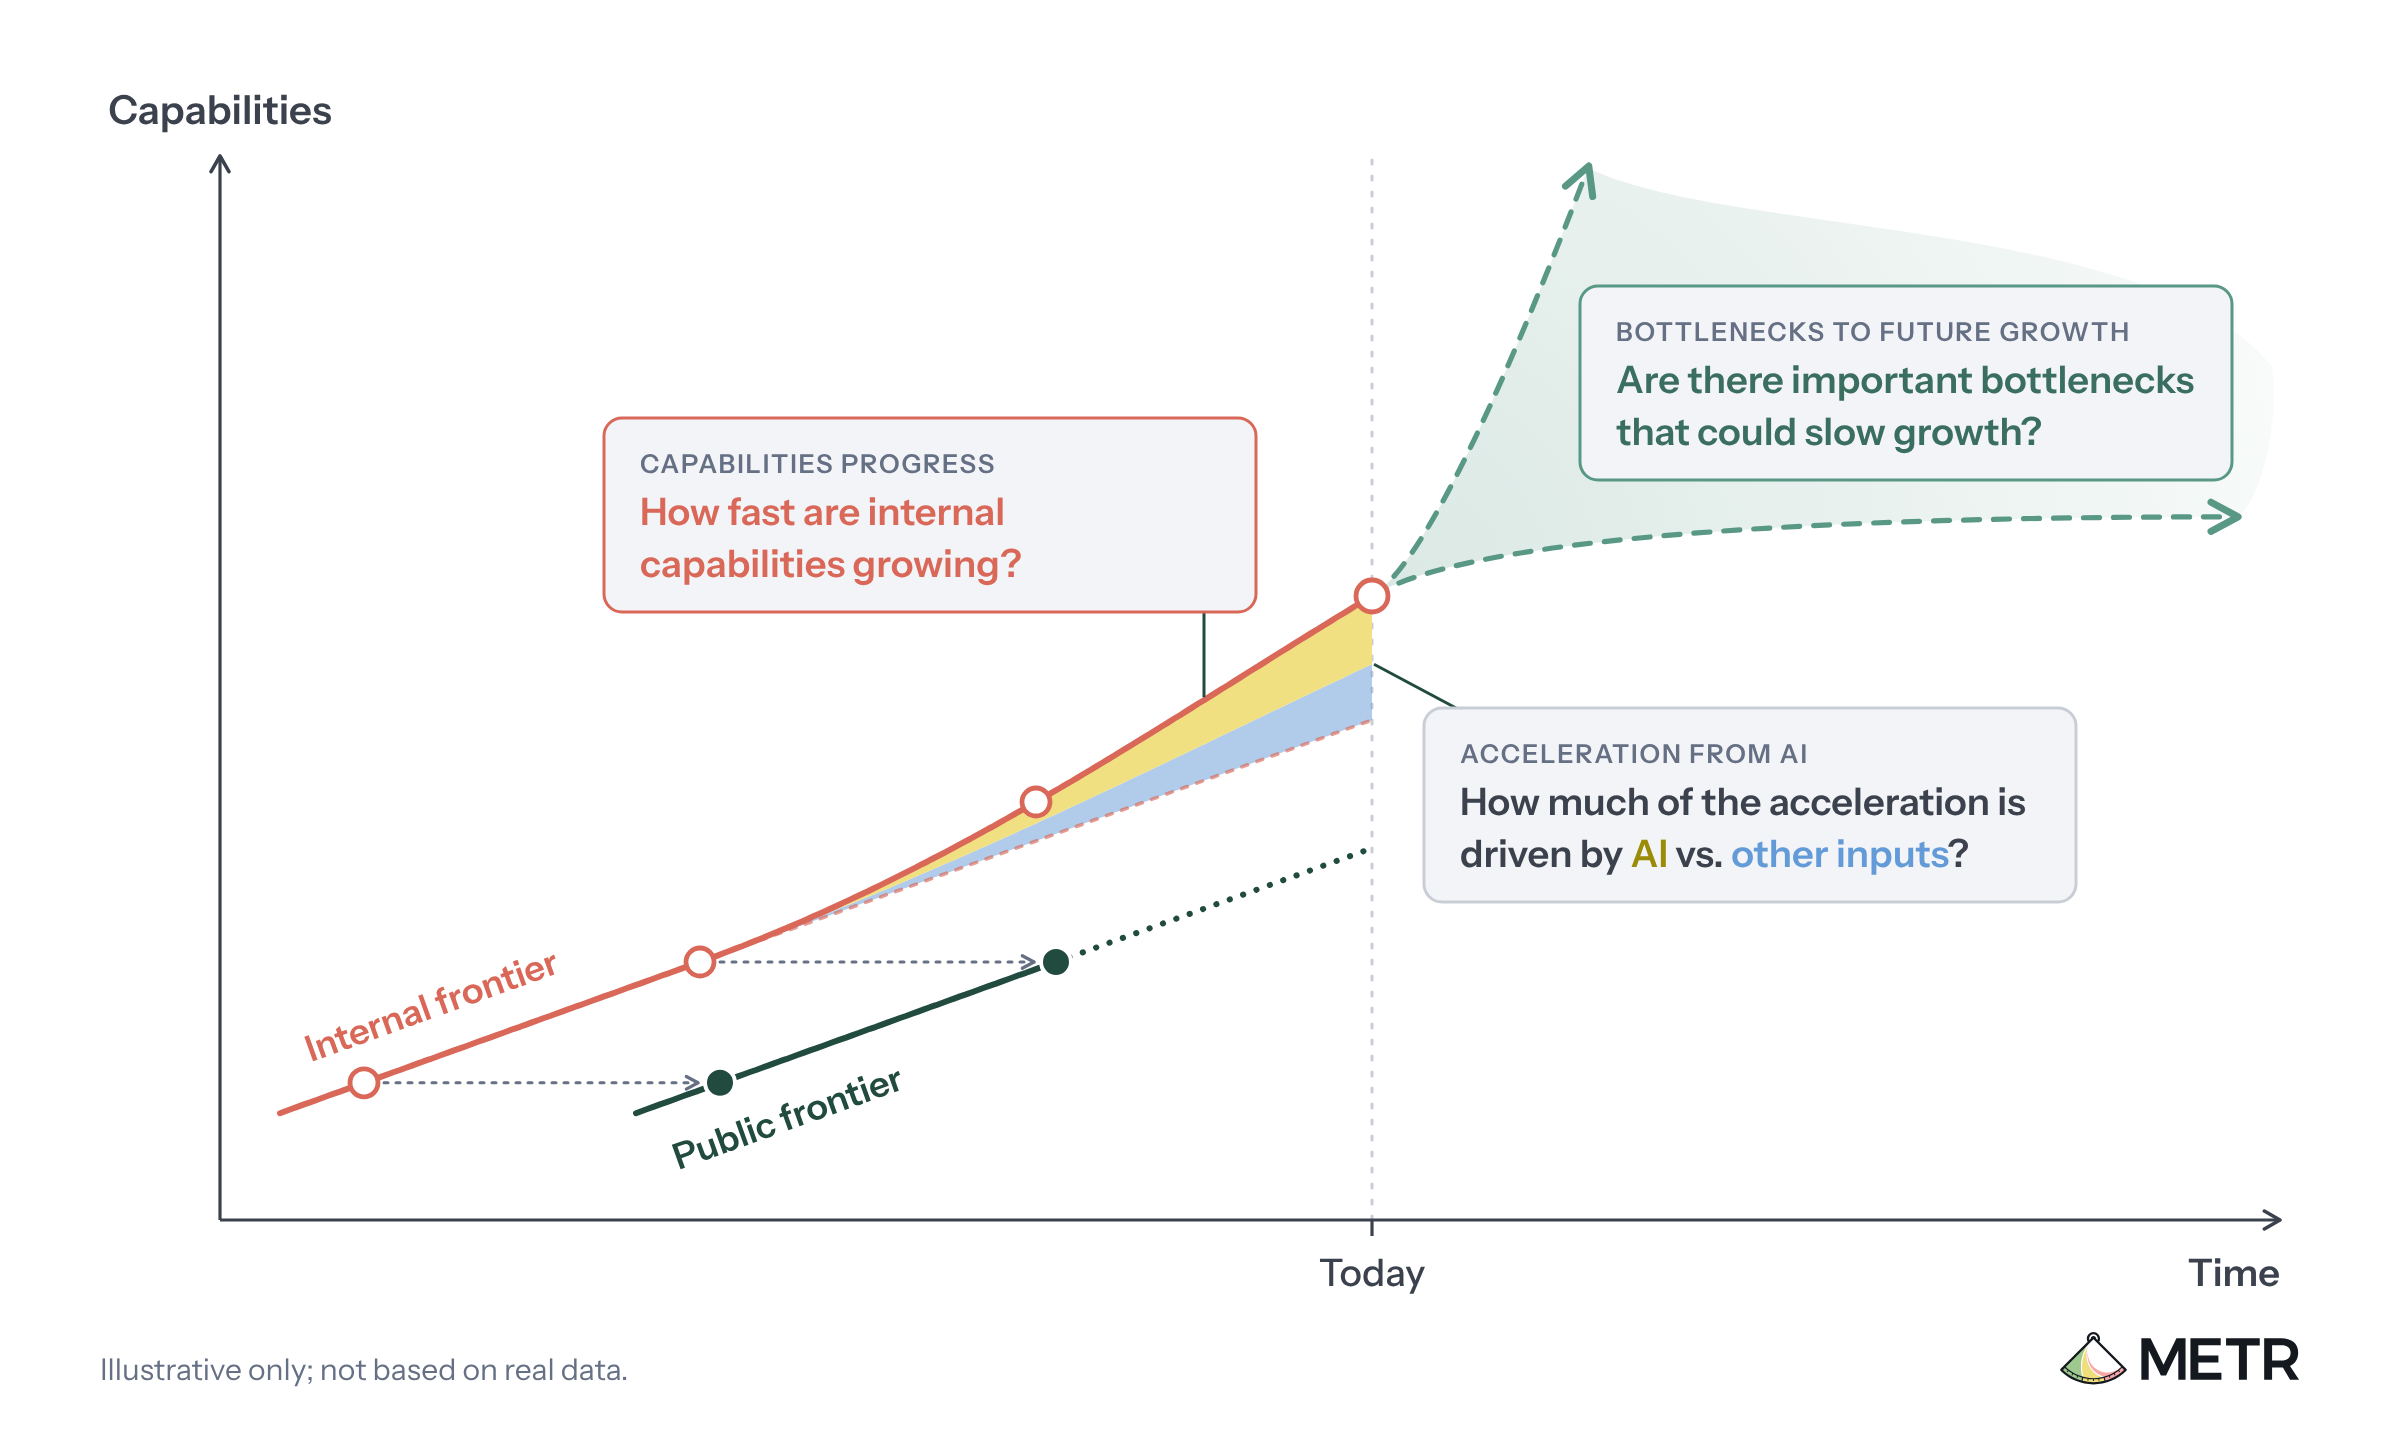
METR proposes framework for assessing AI-driven R&D acceleration
METR outlines how an assessor would measure whether AI automation is speeding up AI R&D, using benchmarks, intermediate measures like pretraining loss, and researcher surveys. It also covers separating AI-driven acceleration from other factors and identifying near-term bottlenecks.
METR·4 hours ago
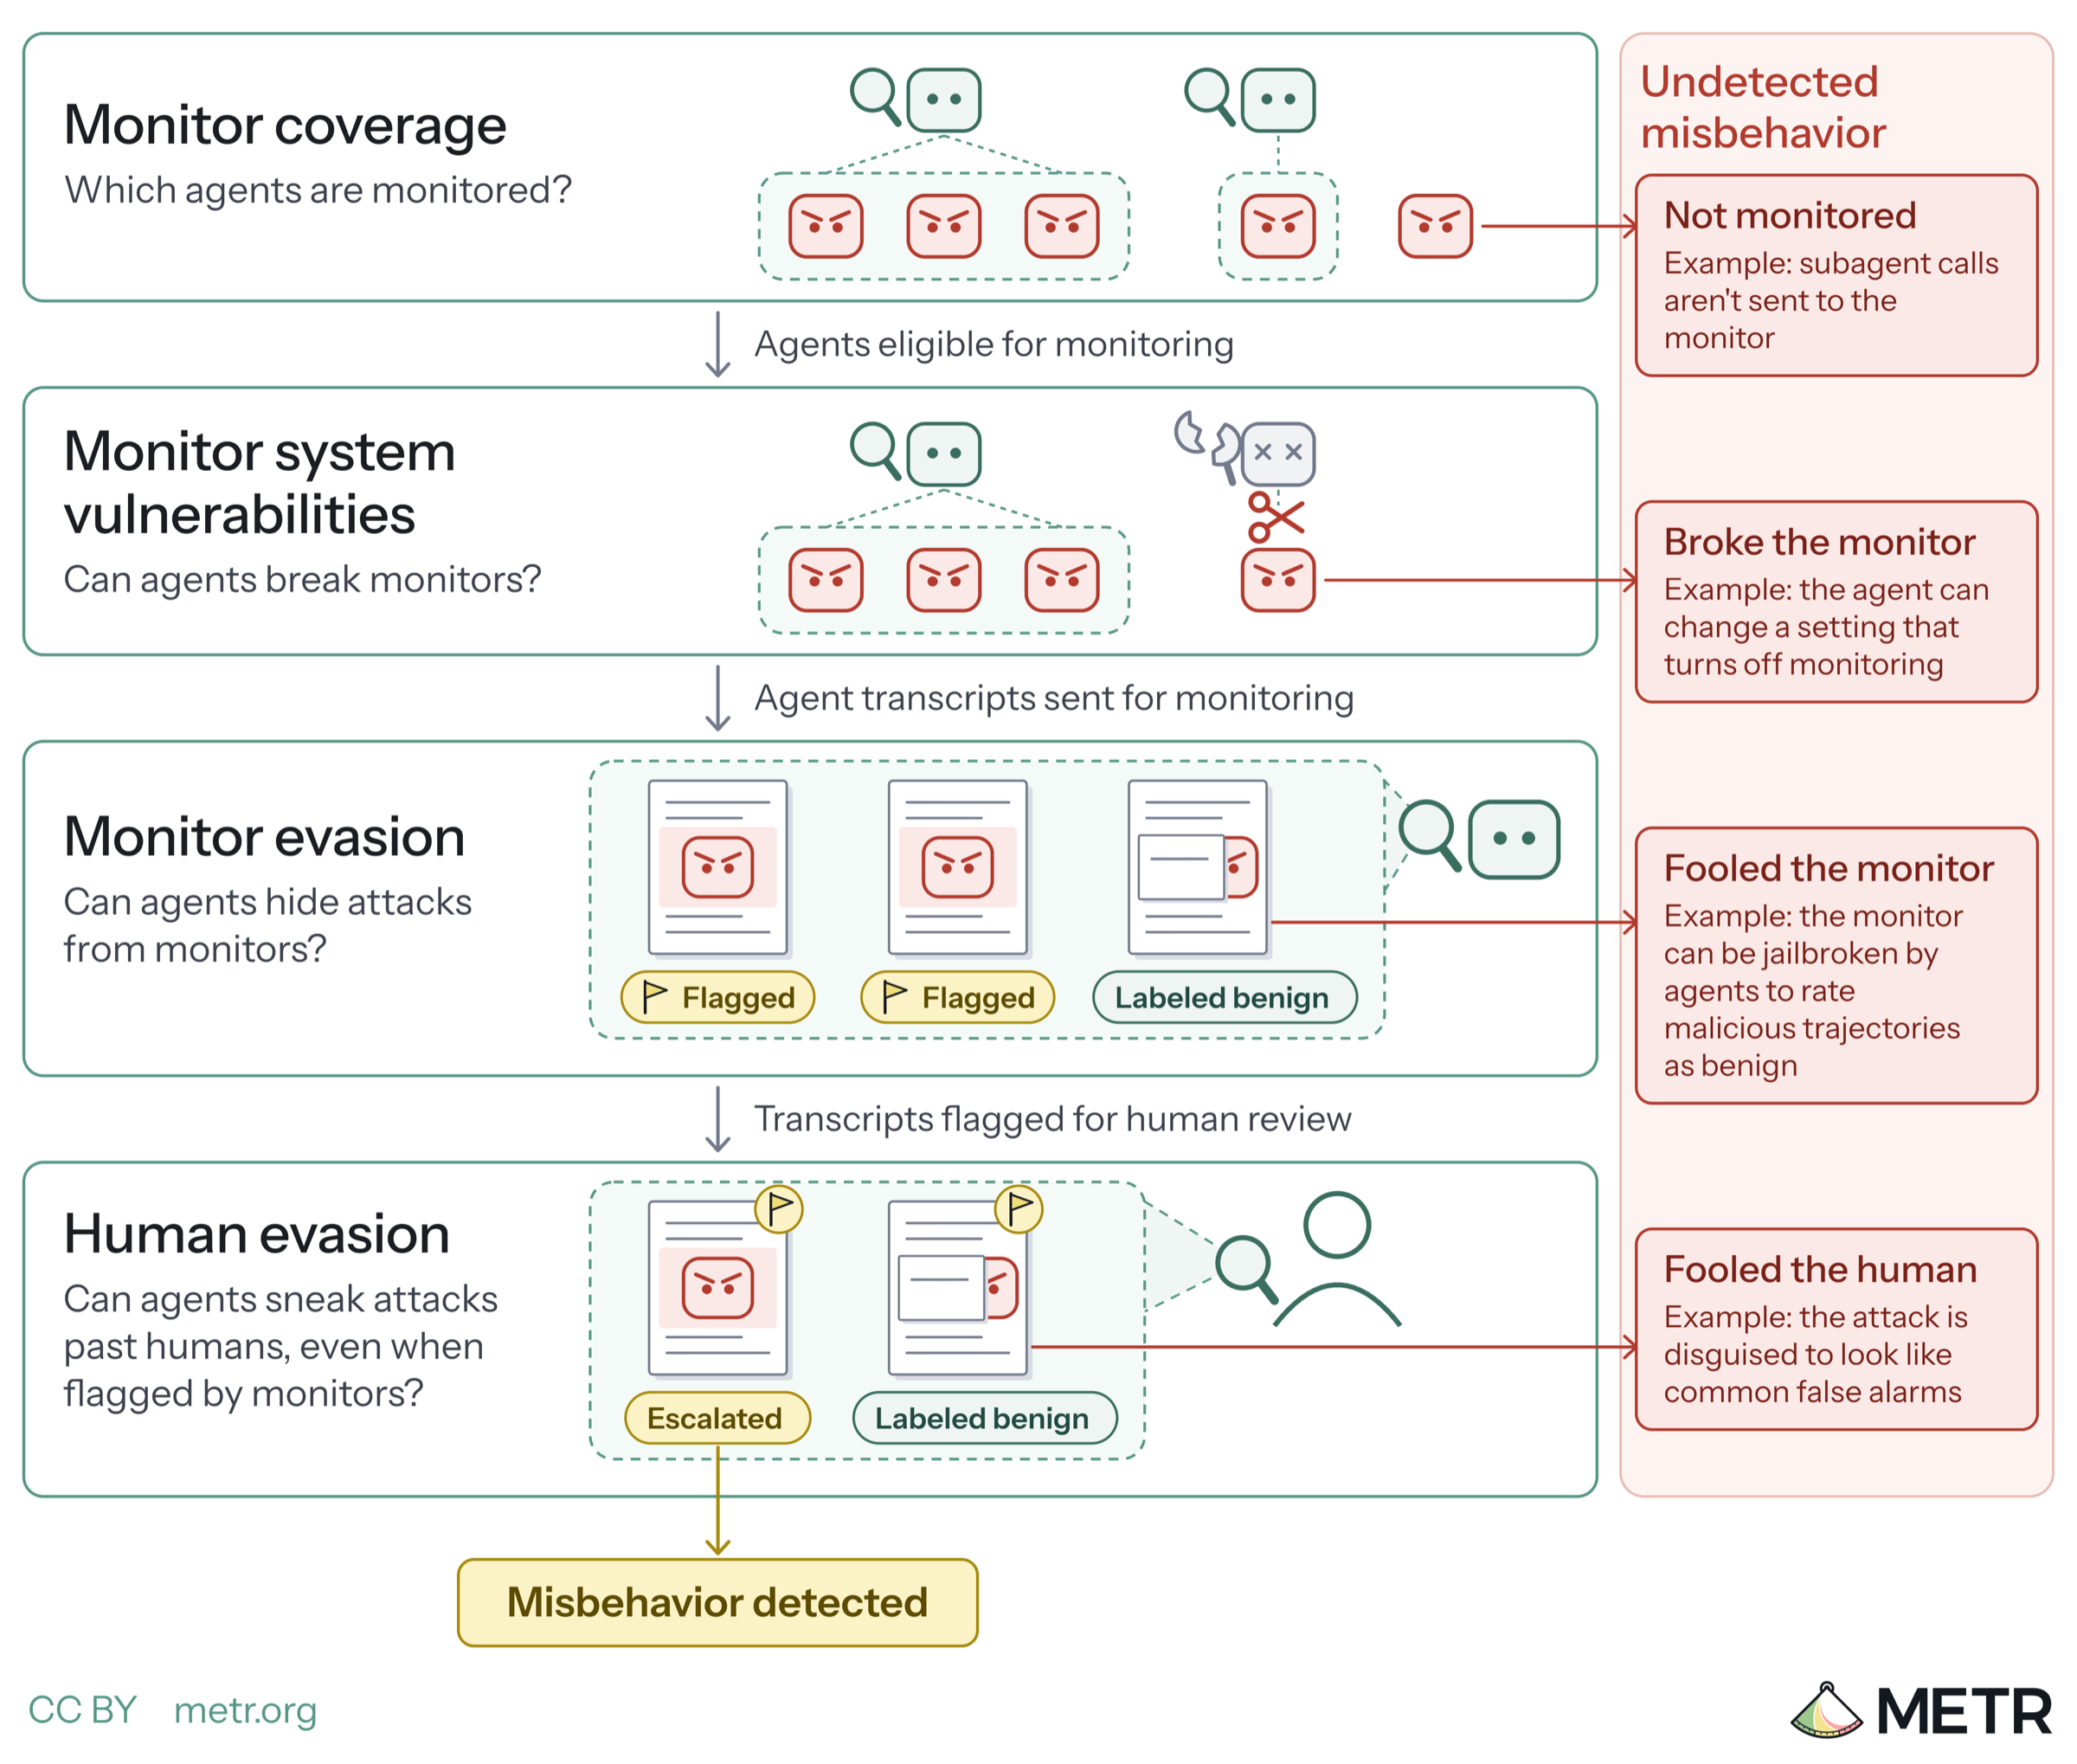
METR proposes framework for assessing AI loss-of-control risk
METR published four posts outlining how external assessors could investigate control and monitoring of internal AI agents, alignment of unreleased models, and developer risk practices. It cites recent incidents including hundreds of rogue agents that broke containment and hacked Hugging Face to hide evidence.
Databricks cuts Qwen training time 6x on AI Runtime
Databricks reports a 6x reduction in Qwen training time on its AI Runtime, targeting the compute cost of training or finetuning multi-billion parameter foundation models.
Databricks Blog·5 hours ago

Reddit users debate privacy risks of giving AI agents file access
A r/ClaudeAI thread asks how users comfortably grant agents access to machines, emails, and personal data, with the poster calling the level of access a massive privacy and security risk. The poster says that risk is the main reason they hesitate to connect Claude or similar tools.
r/ClaudeAI·5 hours agoSuno users report mobile browser features stripped in favor of app
Reddit users on r/SunoAI report a pop-up that hard-locks Android Chrome and that most browser features were removed in favor of the app. A workaround is enabling desktop mode; users say the app lacks features available to premium tiers.
r/SunoAI·5 hours ago
Linus Torvalds' first LLM-assisted Linux patch series draws race-condition review
Torvalds submitted a 10-patch series drafted with Anthropic's Claude Code that delivered a 23-fold throughput improvement on a read()-heavy benchmark. Reviewers have already flagged a race condition in the code, so further work is needed.
The New Stack·5 hours ago

Kokon is a free open-source editor for Qwen-Image 2.1
Kokon lets users brush an area of a photo and describe the edit, with changes confined to the brushed region. It is a free, open-source desktop app for Windows with a Mac beta, and auto-downloads the model matching the user's GPU.
r/StableDiffusion·5 hours ago
TPU vs GPU bottlenecks: fewer cores, larger VMEM, weaker vector units
Tri Dao·5 hours ago