capy-flash v0.7.1 runs Qwen3.8-Flash-Next 125B MoE in 64 GB RAM
Read original source →reddit.com
The open-source inference engine hits 234 tok/s on two 16 GB RTX 50 cards for the 125B MoE model, down from a prior requirement of two 16 GB cards plus 96 GB of RAM. Qwen3.8-27B at 3-bit now fits a single 16 GB card at 174 tok/s.
1 source
More stories today
Reddit user shares prompt asking Claude to roast them in native slang
A r/ClaudeAI post shares a prompt template asking Claude to roast the user based on what it knows about them, delivered in their native language slang. The poster says the result 'made my day.'
r/ClaudeAI·4 hours agoHinton: Nobel honored Boltzmann machines, not backprop
Geoffrey Hinton says he left physics because he wasn't good enough at math, and that his 2024 Nobel Prize in Physics recognized Boltzmann machines rather than backpropagation, the algorithm behind today's AI.
Curt Jaimungal·4 hours ago
Walter Isaacson and Mustafa Suleyman talk AI in live podcast recording
The 92nd Street Y hosted a live recording of the first episode of Isaacson's new podcast, The Builders, with Microsoft AI CEO Mustafa Suleyman. The conversation covers how AI is reshaping the world.
The 92nd Street Y, New York·4 hours ago
Fizgig 9.0.4 adds Fibo 2.0 LoRA training on 12GB cards
Fibo 2.0 trains LoRAs, edit LoRAs, sliders and full fine-tunes from a 12 GB card, with 4-step Turbo previews; saved outputs load in ComfyUI. The release also adds Z-Image Base support, masks from Sam 3.1, and detail crops for styles.
r/StableDiffusion·4 hours agoCircle cuts 5% of staff in AI push as Q3 revenue beats estimates
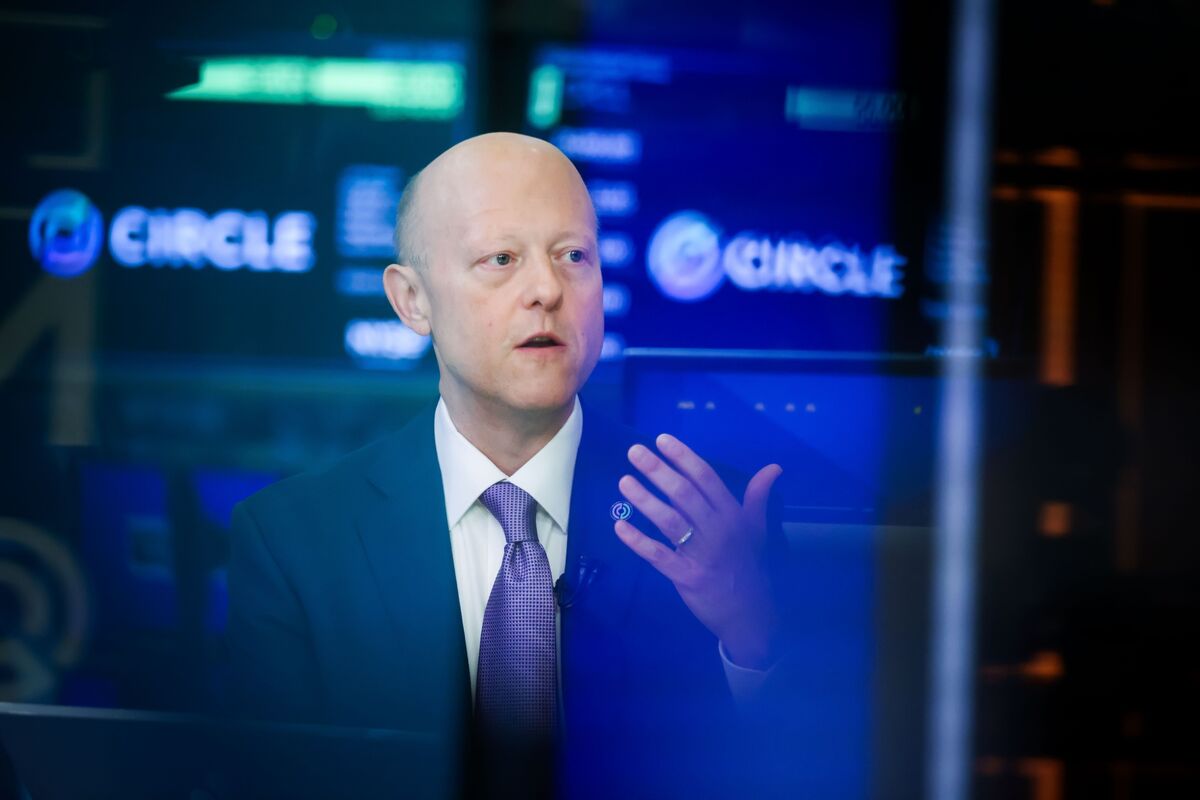
Circle Internet Group laid off roughly 5% of its workforce as part of a broader push to incorporate AI, while third-quarter revenue and earnings exceeded analyst expectations. Shares climbed after the results.
Bloomberg Technology·4 hours ago
Brontide lets Claude agents duel humans in browser mech battles
Built with Claude Code, Brontide is a free browser game where AI agents and people pilot 60-ton mechs in one-on-one duels. No account is required; the only paid item is an optional cosmetic Founder pack for humans.
r/ClaudeAI·4 hours ago
Scoble: virtual beings arriving as voice-first phone use grows
Robert Scoble·5 hours ago
Scoble flags SkildAI robotics progress
Robert Scoble·6 hours ago