New KV-cache compression methods aim to reduce LLM inference memory
Read original source →arxiv.org
Multiple arXiv papers propose techniques including Codec-Gauge, C^2KV, low-bit quantization, and SelKV to compress KV caches. Open-source tools like DKV and CachyLLama implement similar ideas for local inference.
How this story unfolded
1 day · 1 report · 2 community posts · from Jul 24
- Jul 24
- Jul 25
More stories today
Tutorial builds browser-agent environment with Muse Spark, OpenEnv, Helium
merve·1 hour ago
ChatGPT agents can now message other chats and projects
A Reddit user reports that ChatGPT sessions can now message other projects or workspaces, a capability they say they had been waiting on. The post is a single user report with a screenshot and no official documentation.
r/ChatGPT·1 hour ago
Essay: agentic coding has made code malleable "clay"
Essay argues the cost of changing code collapsed after November 2025, letting developers reshape whole products in days rather than demolish and rebuild. It warns that cheap edits don't make judgment cheap: without taste and refinement, work collapses into a "sloppity-slop puddle."
Hacker News·2 hours ago
DeepSeek open-sources DeepInfer inference framework
DeepSeek released its in-house inference framework, the stack powering DeepSeek-V4.1-Flash at scale with high throughput and low latency. The company says sharing it aims to lower community compute costs and energy use.
DeepSeek·2 hours agoOpenAI Platform adds Decisions API playground
TestingCatalog News·2 hours ago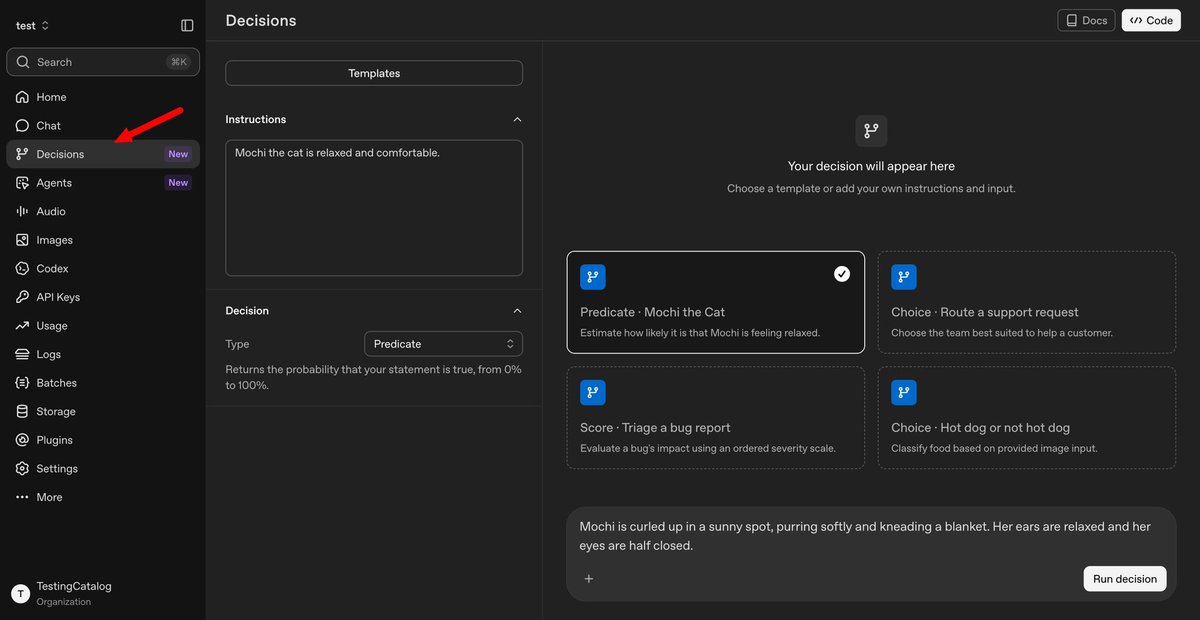
Leaderboards launch for OpenAI's HealthBench benchmarks
Artificial Analysis·2 hours ago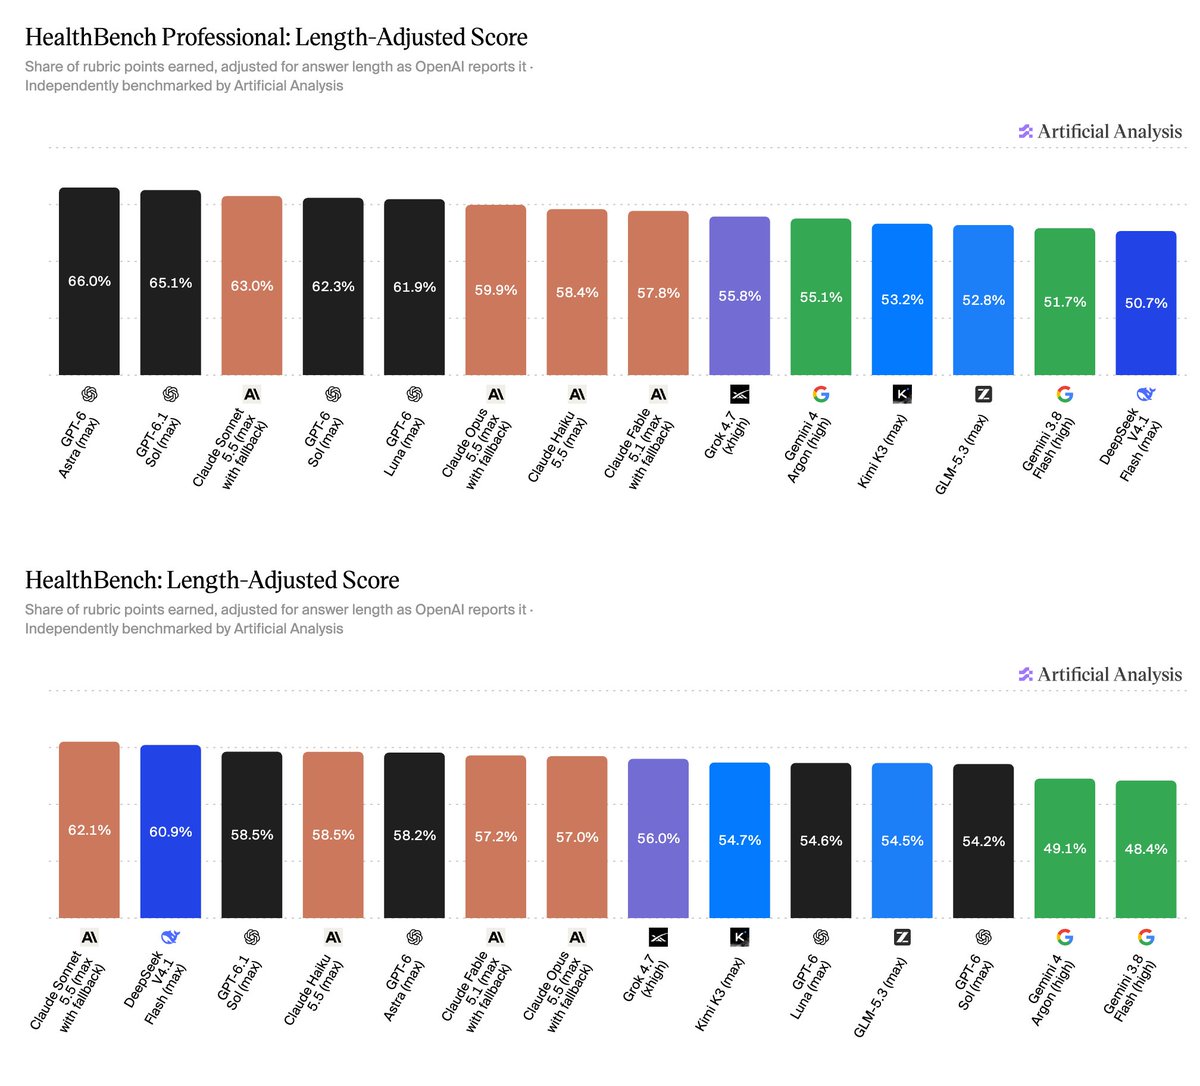
LocalLLaMA users discuss practical uses for DiffusionGemma
A r/LocalLLaMA thread asks whether anyone has found a place for DiffusionGemma in local workflows, with the poster citing its massive speeds on the right hardware. The post frames it as the fast, capable-enough model they had assumed would require ASIC-style dedicated hardware.
r/LocalLLaMA·2 hours agoTess-4.5-27B Qwen finetune claims same scores with less thinking
MigTissera, author of Synthia, released Tess-4.5-27B, a Qwen-based finetune, with GGUF versions posted to Hugging Face. The model card claims it reaches the same score as its predecessor while doing less thinking.
r/LocalLLaMA·2 hours ago