HuatuoGPT-3-27B medical LLM trained with OnePO
Read original source →huggingface.co
HuatuoGPT-3-27B is a medical LLM built on Qwen3.8-27B using One-stage Policy Optimization (OnePO), which adapts models to medicine in a single reinforcement-learning stage without a preceding domain-specific stage.
1 source
More stories today
Pentagon seeks $30.3M for AI-powered lie detector program
The DoD budget request would fund "Polygraph+" over five years, adding AI/ML scoring algorithms and "standoff sensing" that reads physiology without attaching a device. Run by the Defense Counterintelligence and Security Agency, it targets vetting and insider threat detection; Congress has not approved it.
MIT Technology Review AI·2 hours ago

CatBench launches as a fluffier LLM benchmark alternative
A Reddit user announced CatBench at catbench.noip.ws, pitched as a safer alternative to AssBench for testing LLM content restrictions. No methodology, model results, or scoring details were provided.
r/OpenAI·2 hours ago
Qwen3.8 27B used for practical 3D printing modeling
A Reddit user ran Qwen3.8 27B on an RTX 5090 and Qwen Image 2.1 on a 10GB RTX 3080 with ComfyUI to produce practical 3D-printing work for a Bambu H2C printer, spending about a day and a half on the attempt.
r/LocalLLaMA·2 hours ago
Laya gains OpenVINO support, 3.4x faster than PyTorch on CPU
OpenVINO backend for Laya runs 40 ms per question on CPU, a 3.4x speedup over PyTorch. Code and a Flappy Bird demo are published on GitHub.
r/LocalLLaMA·2 hours ago
Pirate Wires: Jacob Coxon tied to AI PR firm DEY.
Pirate Wires·2 hours ago
Self-hosted email client runs AI agent on Cloudflare Workers
Tom Doerr·3 hours ago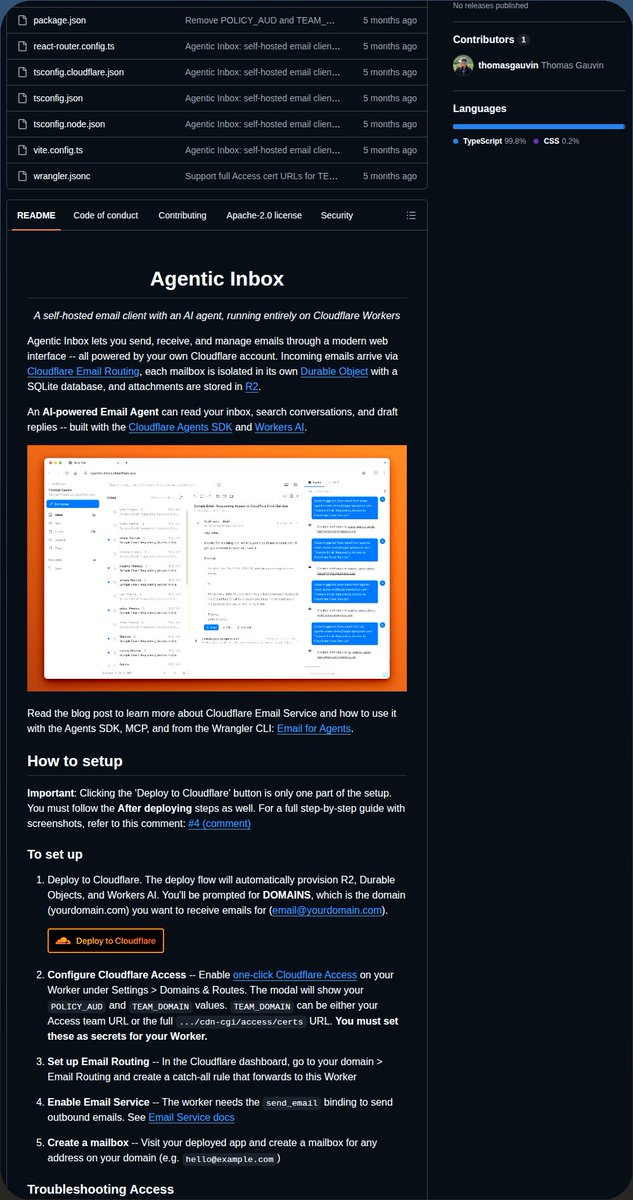
Reddit user tests Claude on procedural Three.js 3D horse
A r/ClaudeAI user prompted Claude to build a low-poly 3D horse running in a seamless loop with Three.js, procedurally from primitive geometry, returning a single self-contained HTML file. The user says the "Max" run took a whole hour and asks which version produced the best result.
r/ClaudeAI·4 hours ago
YouTube video covers GPT-6 and GPT Sites changes
A Ben AI YouTube video titled "NEW GPT-6 + GPT Sites Changes Everything (Build Anything)" discusses GPT-6 and GPT Sites. The cluster contains only this video's promotional description, with no article, official announcement, or corroborating source.
YouTube·5 hours ago