Guide compares decision models for automated evals
Read original source →hamel.dev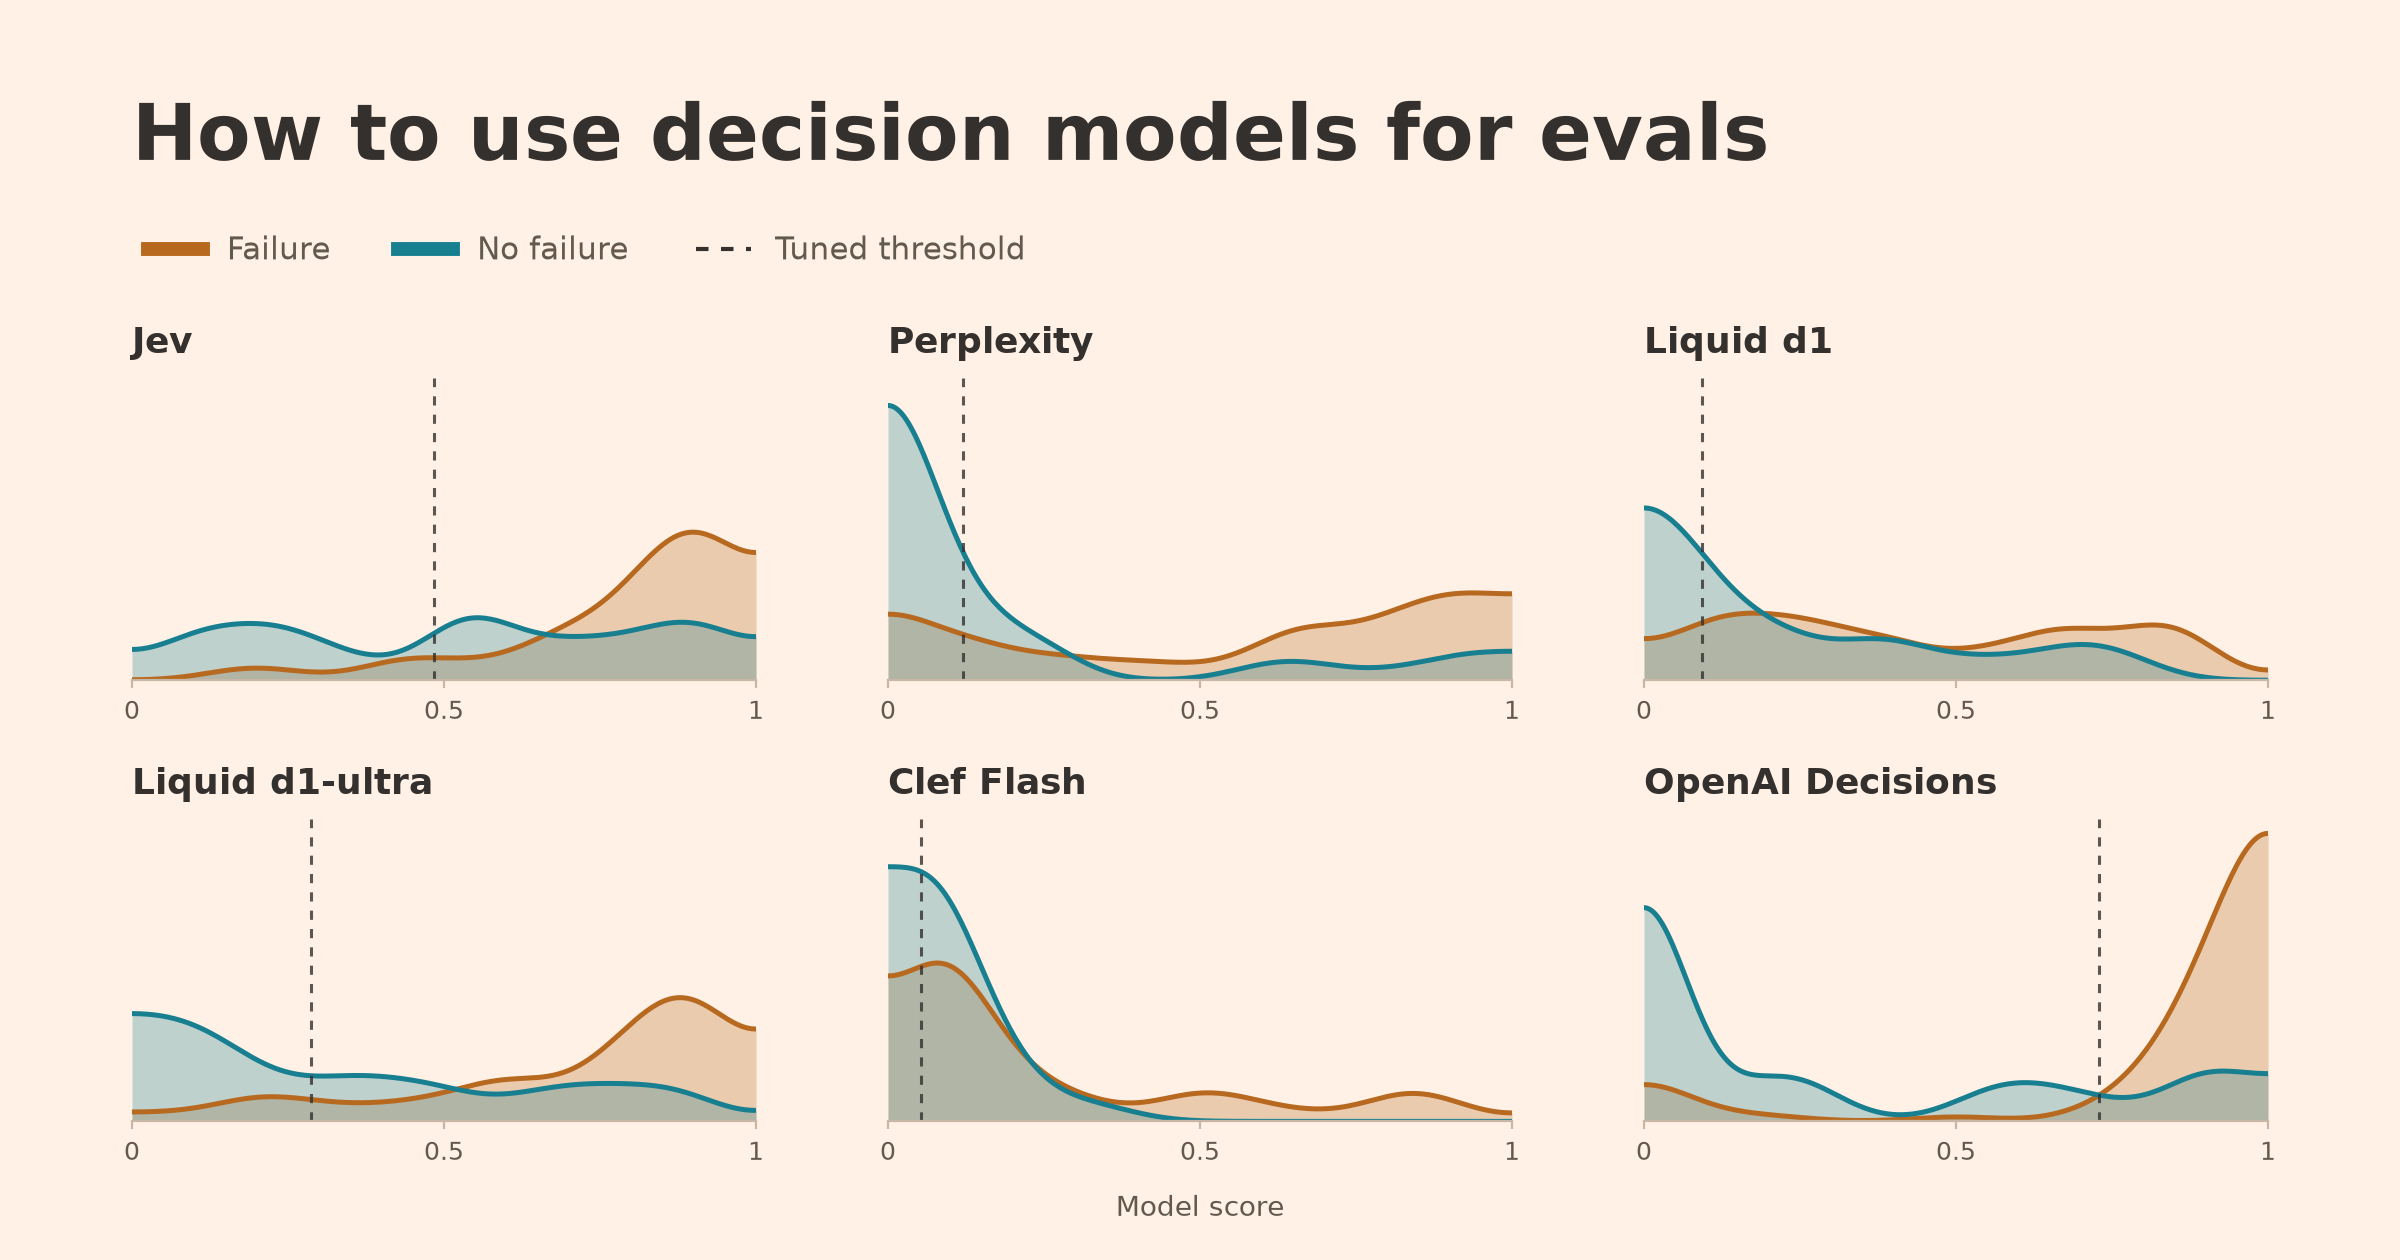
Hamel Husain's post benchmarks Jev 1.13, Perplexity Decider 1.1 27B, Liquid d1/d1-ultra, Cloudflare Clef Flash and OpenAI Decisions (GPT-6 Luna) on 100 apartment-leasing agent traces for failure detection. It argues the default 0.50 threshold leaves performance on the table and covers calibration of scores as confidence estimates.
1 source
More stories today
ComfyUI user tests MiniMax H3 acting in argument scene
A ComfyUI user experimenting with refmods and motion context found MiniMax H3's acting in a multi-character argument scene notably convincing. H3 had been out for a while before the user tried it.
r/ComfyUI·3 hours ago
Reddit post proposes 'bread and circuses' benchmark for AI entertainment
A r/Singularity post argues top labs should focus on AI that can entertain people, citing Opus 5.5's taste and video capabilities and calling for real audio plus a similar taste leap in the next update.
r/Singularity·3 hours ago
Reddit post claims first phases of 'pyramid replacement' at Anthropic
A r/ClaudeAI gallery post links to intelligence-curse.ai/pyramid/ and asserts that early phases of a "pyramid replacement" are underway at Anthropic. The post carries no cited figures, documents, or official confirmation.
r/ClaudeAI·4 hours ago
Pilot Light keeps Claude Code running on MacBook at 4.8 W or less
A Reddit user built Pilot Light, a power-saving caffeinate variant, so Claude Code keeps running with the lid closed. Idle draw with the lid open measured 16.7 W, with the screen consuming most of it.
r/ClaudeAI·4 hours ago
Ant Group's Ming-3.0-tts debuts at #18 on TTS Arena
Ming-3.0-tts scored 1187.8 on Artificial Analysis's blind-vote Text-to-Speech Arena. Qwen-Audio-3.0-TTS-Plus (Alibaba) leads the snapshot at 1264.0, ahead of Breeze TTS 2 at 1221.4 and Gemini 3.1 Flash TTS at 1212.0.
Artificial Analysis Leaderboard·4 hours ago
Reddit researcher: AI idea generation outpaces experiment testing
An r/MachineLearning poster says AI now generates research directions and smoke-run implementations far faster than they can be tested, making experimentation the bottleneck. They describe one AI session reviewing 30 papers they had collected.
r/MachineLearning·4 hours agoUtopai X tops Artificial Analysis Text-to-Video Arena
Utopai Studios' Utopai X scored 1165.6 to take #1, edging ByteDance Seed's Dreamina Seedance 2.5 at 1159.2 and FLUX 3 Max (720p) at 1159.0. MiniMax H3 (768p) and MiniMax H3 Max followed at 1158.2 and 1155.6 in the blind-vote arena.
Nadella discusses how security leaders can prepare for superintelligence
Microsoft Chairman and CEO Satya Nadella joins Hayete Gallot in a fireside chat on preparing security teams for agent systems that can reason, act, and operate across the enterprise. The conversation covers the next frontier of cyber defense.
Microsoft Security·4 hours ago