Prime Intellect releases Prime Mega MoE training kernel
Read original source →marktechpost.com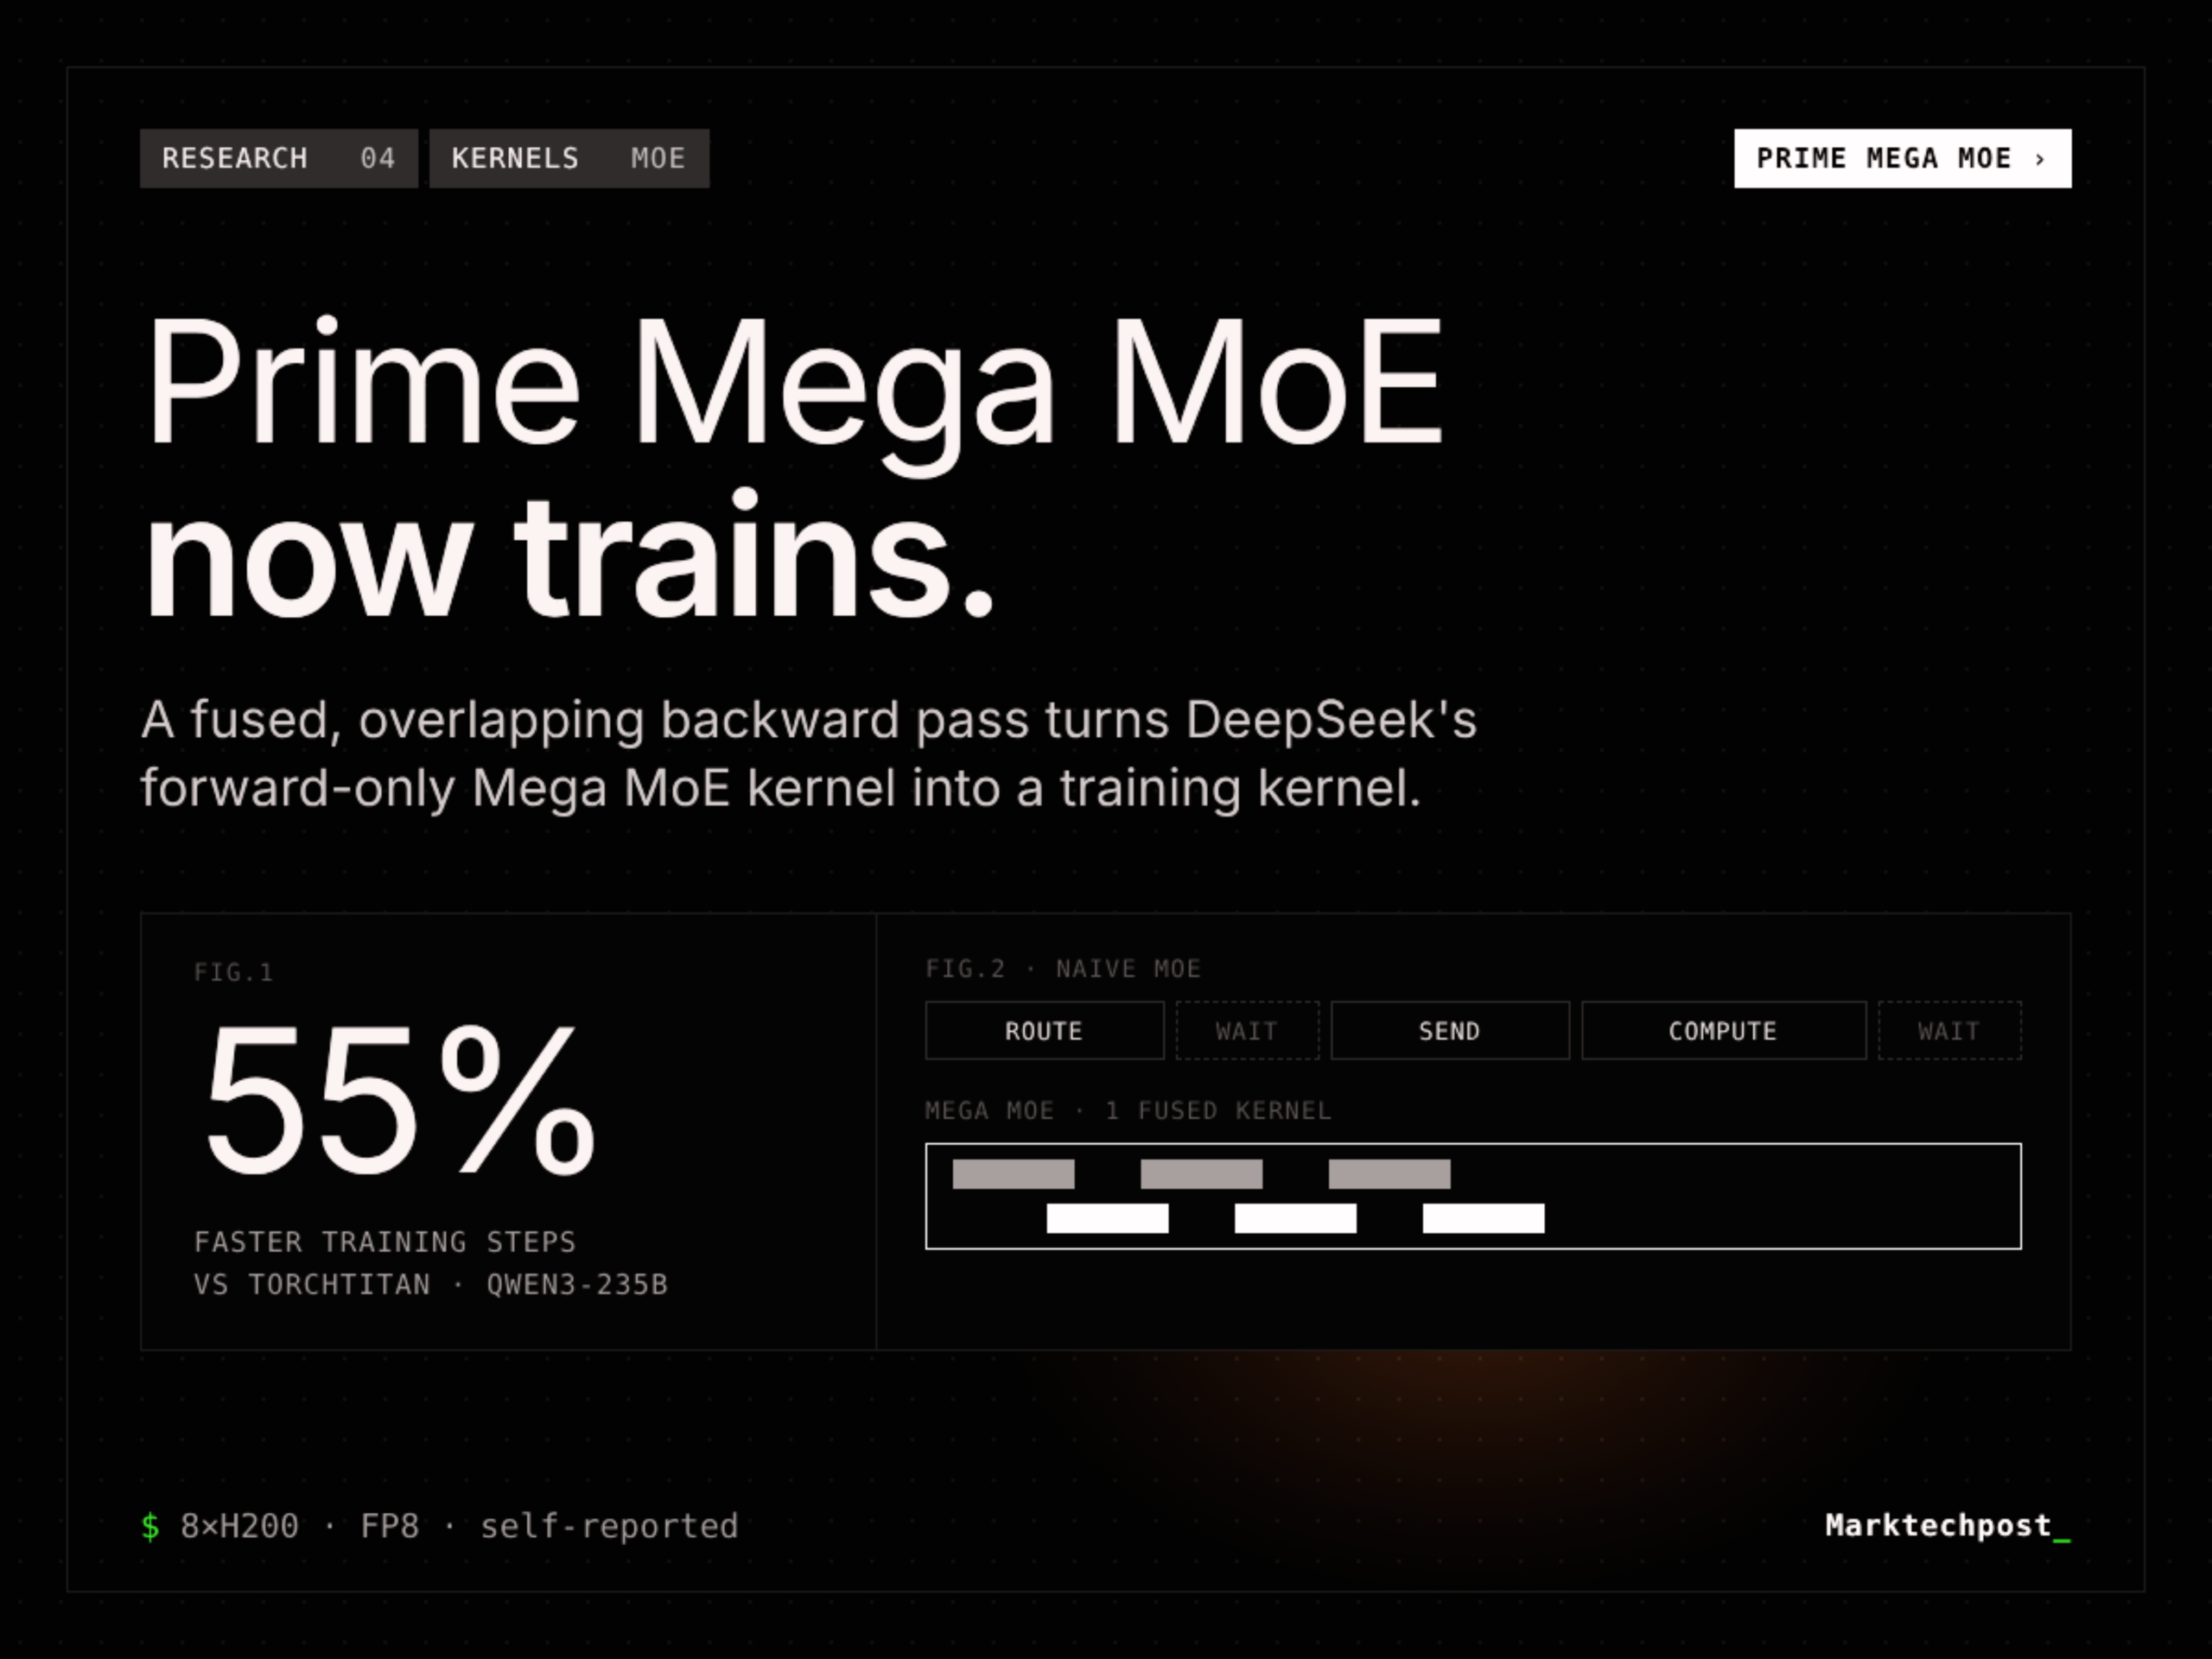
Prime Intellect extended DeepSeek's fused Mega MoE kernel with an overlapping backward pass, making it usable for training rather than inference only. Full training steps on Qwen3 MoE models run 32-34% faster in prime-rl and 48-55% faster than TorchTitan.
1 source
More stories today
Altman: OpenAI weighed flat-fee pricing, backed off after feedback
OpenAI considered dropping token-based pricing for its next model, letting developers submit a prompt and get a price for the work, before negative customer feedback reversed the plan, Sam Altman said. He spoke Thursday.
The New Stack·1 hour ago

DeepMind launches economics of AGI research program
Alex Imas·1 hour ago
Speridlabs' Idol turns a single image into a 3D Gaussian splat
Idol converts one photo, render, or generated image into up to 1,048,576 Gaussians, output as a standard 3DGS .ply file. It strips the background and frames the object automatically, running on consumer GPUs at 7.2 GB of VRAM.
r/StableDiffusion·1 hour ago
AWS Hydro team builds compiler checks for AI coding agents
Hydro, an open-source Rust framework for distributed systems, added a way to verify a system still works correctly when it resends messages after a failure. Shadaj Laddad said the resulting change was "like a 5000 line PR."

Claude API max request size raised from 32 MB to 128 MB
Claude Developers·1 hour ago
Reddit users accuse Cohere of unscientific fear-mongering blog post
r/LocalLLaMA users argue Cohere's post on "concerning behaviour" in a popular open-weight model relied on extensive pre-filling and prompting, drawing wide media coverage and fear-mongering headlines from what critics call an unscientific experiment.
r/LocalLLaMA·1 hour ago
YC Labs runs AI agent swarms in Minecraft and Mindustry
YC Labs partnered with Olam Labs to test multi-agent dynamics, running 50 GPT-6.1 Sol agents in a survival Minecraft world for 3 hours with the goal "Build a t..." and a 25-agent GPT-6.1 Terra colony. The Minecraft harness, built on Mineflayer with a Pi-driven agentic loop, is open-sourced.
Hacker News·2 hours ago
Swift 1.5 Flash Next Heretic v2 quant released on r/LocalLLaMA
Community release pairs jeffpeng3's v2 heretic weights with a new quantization and imatrix recipe from u/jjusko20. The poster says v2 preserves both reasoning ability and output length, calling it a big step up from the v1 weights.
r/LocalLLaMA·2 hours ago